본 문서는 영어 원본을 기계 번역한 것입니다. 번역본과 영어 원본 사이에 내용이 상충할 경우 영어 원본이 우선합니다. 영어 원본 보기
거대한 개인 데이터 학습 파이프라인
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
목요일 오후 4시 40분. 승인된 어시스턴트는 한도에 도달했거나, 계약서 검토에 신뢰할 만한 모델이 아니거나, 계약서가 저장된 드라이브에 접근할 수 없습니다. 마감 시한은 그대로인데, 직원은 "AI 네이티브"로서 일하기를 기대받습니다. 결국 그녀는 계약서를 개인 ChatGPT에 붙여넣고, 30초 만에 알기 쉬운 요약과 함께 결정을 내립니다.
이 과정에서 누구도 정보가 유출되었다고 생각하지 않으며, 이는 지극히 합리적인 AI 활용처럼 보입니다. 하지만 저는 이것이 업계에서 가장 거대한 데이터 파이프라인이며, 서비스 약관의 작은 몇 마디 문구를 통해 작동하고 있다고 생각합니다.
두 가지 규칙
OpenAI는 기본적으로 기업 고객의 데이터를 학습에 사용하지 않지만, ChatGPT를 사용하는 개인의 경우 "모델을 개선하기 위해 귀하의 콘텐츠를 사용할 수 있습니다." Anthropic은 "이 설정이 켜져 있을 때" 일반 사용자 채팅 데이터를 학습에 사용하며, 비즈니스 및 API 사용은 제외됩니다. 유럽 외 지역에서는 Google의 무료 개발자 API가 수신한 데이터를 학습하지만, 유료 API는 그렇지 않습니다. xAI는 한 걸음 더 나아갑니다. EU 및 영국 외 일부 지역에서는 로그인하지 않고 Grok을 사용할 경우 학습 제외(옵트아웃)가 전혀 불가능합니다.
소비자 대상 서비스는 명쾌한 전제에 기초합니다. 즉, 입력하는 사람이 입력한 내용의 소유자이며, 이를 공유하는 데 동의했다는 것입니다. OpenAI의 이용 약관은 사용자가 이를 제공할 모든 권리를 가지고 있음을 "진술 및 보증"하도록 규정합니다.
문제는 그 계약서가 고용주의 기밀 정보이며, 그 안의 이름들은 고객의 개인정보라는 점입니다. 어느 쪽도 승인하지 않았지만, 이제 그 데이터는 클라우드라는 거대한 데이터 보존 끈끈이에 달라붙어 버렸습니다. 해고에 대한 불안, 더 빠른 업무 처리에 대한 기대, 그리고 "AI 네이티브"로 보여야 한다는 압박감은 체계적이고 지속적인 기술적 데이터 유출을 낳았습니다. 이는 고객의 신뢰뿐만 아니라 명문화된 회사 정책을 위반하는 행위입니다.
세탁의 굴레
소비자용 약관 하에서는 직원이 붙여넣은 내용, 작업 방식, 결론 도출 과정 전체가 학습 데이터가 될 수 있습니다. 이후 회사가 엔터프라이즈 버전을 구매하면 출처는 말끔히 지워지고, 아이디어 파티클보드처럼 재가공되어 사용자(seat)당 과금 형태로 그 학습 결과물을 되사오게 됩니다. 개인용 약관과 상업용 약관의 분리는 기밀 정보와 개인정보의 세탁 루프(laundry loop)이자, 아무도 주목하지 않는 영업비밀 유출 경로입니다. 비용도 만만치 않습니다. IBM의 조사에 따르면 5개 조직 중 1곳이 섀도 AI로 인한 유출 피해를 겪었으며, 섀도 AI 사용 비중이 높은 경우 67만 달러의 비용이 추가로 발생했습니다.
정책만으로는 유출을 막을 수 없는 이유
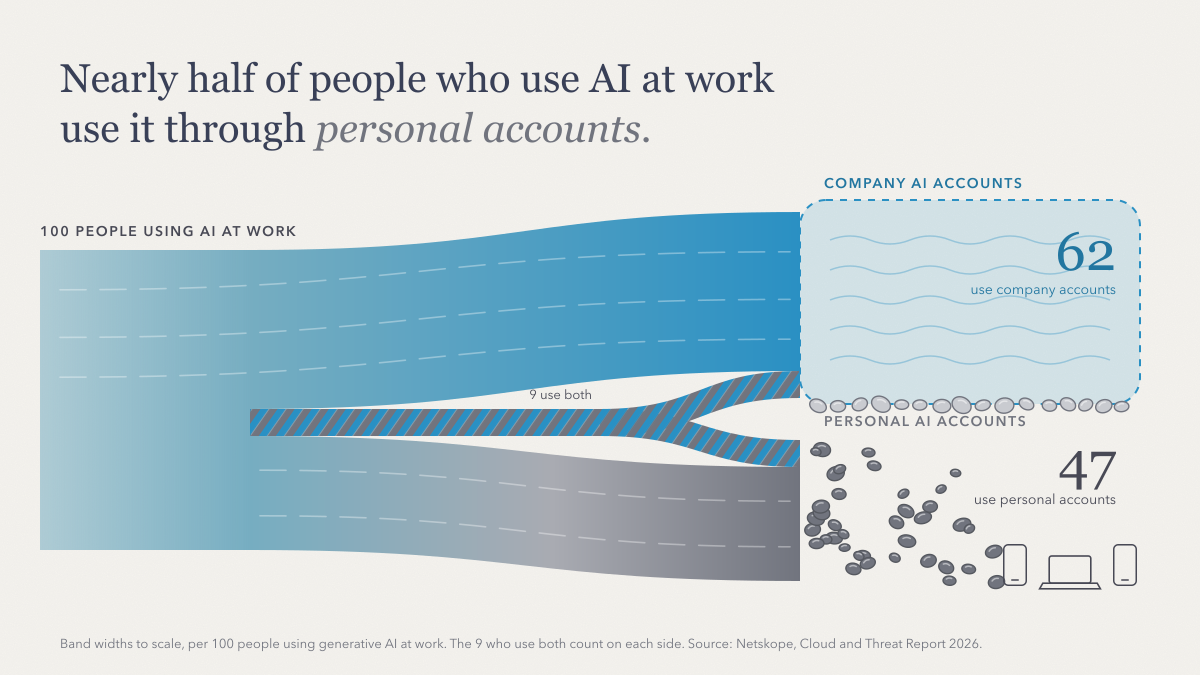
Netskope에 따르면 직장에서 생성형 AI를 사용하는 사람의 47%가 개인용 AI 앱을 사용하고 있으며, 10개 조직 중 9개는 이미 최소 하나 이상의 AI 앱을 차단하고 있습니다. 그럼에도 이런 일이 발생하는 이유는 사내 승인 도구에 사용자가 선호하는 모델이 없거나 업무에 필수적인 파일, 저장소, 시스템에 접근할 수 없기 때문입니다. AI 비용을 지불하는 기업을 대상으로 한 Zapier의 설문조사에서 개인 계정 사용자의 53%는 자신이 쓰던 도구를 선호했고, 33%는 회사의 도구가 자신의 필요에 맞지 않는다고 답했습니다. 차단 정책은 단지 복사해서 붙여넣는 위치를 스마트폰으로 옮겨갈 뿐입니다.
세탁 루프를 끊어내는 방법
AI 연구소들이 악당이라고 생각하지는 않습니다. 이러한 회색지대는 거의 모두에게 이득이 됩니다. 직원은 업무를 마치고, 고용주는 결과물을 얻고, 연구소는 데이터를 확보합니다. 이 거래에서 빠져 있는 유일한 주체는 데이터의 소유자뿐입니다.
이 연결고리를 끊는 방법은 사람들이 자발적으로 선택할 만한 공식 승인 도구를 제공하는 것입니다. 이것이 바로 제가 Caiioo를 만든 이유입니다.
Caiioo는 모든 주요 모델을 구동하며, 자체 하드웨어에서 오픈 모델도 실행할 수 있습니다. 모델을 바꾸는 것은 자동차의 엔진을 교체하는 것과 같습니다. 대화 내용, 파일, 설정은 그대로 유지됩니다.
AI를 여러분의 업무 환경으로 직접 가져옵니다. 파일, 이메일, 캘린더는 또 다른 클라우드에 업로드되지 않고 본인의 기기에서 바로 연결되며, 대화 내용은 종단간 암호화되어 본인의 기기에서만 읽을 수 있습니다.
또한 모든 요청이 어디로 전송되는지 명확히 보여줍니다. Trust Boundary는 어떤 AI 기업이 데이터를 수신하고 약관상 무엇이 허용되는지 나열하며, 스위치 하나로 데이터 학습 가능성이 있는 모든 제공업체를 차단할 수 있습니다. 기업이 서류상의 정책을 모든 구성원에게 적용되는 실질적인 규칙으로 전환할 수 있도록 동일한 제어 기능을 구축하고 있습니다.
역량, 자율성, 보안을 중요하게 생각하기에 Caiioo를 시작했습니다. 저는 승자 한 곳을 점찍거나 특정 AI 기업 하나에 종속되고 싶지 않습니다. 이미 너무 많은 권력이 집중되어 있습니다. 기업은 이러한 도구를 활용하는 동시에 데이터를 보호하고 독립성을 유지해야 합니다.