یہ اصل انگریزی دستاویز کا مشینی ترجمہ ہے۔ اس ترجمے اور اصل انگریزی ورژن کے درمیان کسی بھی تضاد کی صورت میں، انگریزی ورژن ہی معتبر تصور ہوگا۔ اصل انگریزی ورژن پڑھیں
ذاتی ڈیٹا کی ٹریننگ کی عظیم پائپ لائن
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
جمعرات کے سہ پہر ۴:۴۰ بجے ہیں۔ منظور شدہ اسسٹنٹ اپنی حد تک پہنچ چکا ہے، یا یہ وہ ماڈل نہیں جس پر وہ معاہدوں کے لیے بھروسہ کرتی ہے، یا اس ڈرائیو تک رسائی حاصل نہیں کر پا رہا جہاں معاہدہ موجود ہے۔ ڈیڈ لائن وہی ہے، اور اس سے "AI Native" بننے کی توقع کی جا رہی ہے۔ چنانچہ وہ معاہدے کو اپنے ذاتی ChatGPT میں پیسٹ کرتی ہے اور، تیس سیکنڈ بعد، اس کے پاس ایک آسان فہم پڑھت اور فیصلہ تیار ہوتا ہے۔
اس کہانی میں کوئی بھی یہ نہیں سوچتا کہ کچھ لیک ہوا ہے، اور یہ AI کا ایک بالکل معقول استعمال ہے۔ میرے خیال میں یہ انڈسٹری کی سب سے بڑی ڈیٹا پائپ لائن ہے، اور یہ سروس کی شرائط کے چند معمولی الفاظ کے ذریعے چلتی ہے۔
قواعد کی دو کتابیں
OpenAI پہلے سے طے شدہ طور پر کاروباری صارفین کے ڈیٹا پر تربیت نہیں کرتا، لیکن ChatGPT استعمال کرنے والے انفرادی صارفین کے لیے یہ "ہمارے ماڈلز کو تربیت دینے کے لیے آپ کا مواد استعمال کر سکتا ہے"۔ Anthropic صارفین کی چیٹس پر تربیت کرتا ہے "جب یہ سیٹنگ آن ہو"؛ کاروباری اور API کا استعمال اس سے مستثنیٰ ہے۔ یورپ سے باہر، Google کا مفت ڈیولپر API جو کچھ وصول کرتا ہے اس پر تربیت حاصل کرتا ہے؛ جب کہ ادا شدہ API ایسا نہیں کرتا۔ xAI اس سے بھی آگے جاتا ہے: EU اور برطانیہ سے باہر کچھ خطوں میں، اگر آپ لاگ ان کیے بغیر Grok استعمال کرتے ہیں، تو آپ تربیت سے بالکل بھی آپٹ آؤٹ نہیں کر سکتے۔
صارف کا پہلو ایک واضح مفروضے پر مبنی ہے: جو شخص ٹائپ کرتا ہے وہ اپنی تحریر کا مالک ہے اور اس نے اسے شیئر کرنے کی رضامندی دی ہے۔ OpenAI کی شرائط میں صارفین سے "تصدیق اور ضمانت" لی جاتی ہے کہ انہیں یہ فراہم کرنے کا پورا حق حاصل ہے۔
مسئلہ یہ ہے کہ وہ معاہدہ اس کے آجر کی خفیہ معلومات ہے، اور اس میں درج نام کسی کلائنٹ کا ذاتی ڈیٹا ہیں۔ کسی نے بھی کسی چیز کی منظوری نہیں دی، اور اب یہ کلاؤڈ میں ڈیٹا برقرار رکھنے کے ایک بڑے جال میں پھنس چکا ہے۔ ملازمت کے خاتمے کا خوف، کام کی فوری تکمیل کی توقعات اور "AI Native" نظر آنے کے دباؤ نے ایک منظم، مسلسل تکنیکی ڈیٹا کی خلاف ورزی کو جنم دیا ہے: گاہک کے اعتماد اور کمپنی کی تحریری پالیسی دونوں کی کھلی خلاف ورزی۔
لانڈری لوپ
صارف کی شرائط کے تحت، اس نے جو پیسٹ کیا، جس طرح اس پر کام کیا اور جو نتیجہ اخذ کیا، وہ سب ٹریننگ ڈیٹا بن سکتا ہے۔ جب اس کی کمپنی بعد میں انٹرپرائز ورژن خریدتی ہے، تو اسے وہ تمام سیکھ منبع صاف کر کے واپس ملتی ہے، خیالات کے پارٹیکل بورڈ کے طور پر دوبارہ استعمال ہوتی ہے اور فی سیٹ فروخت کی جاتی ہے۔ ذاتی اور تجارتی شرائط کے درمیان کا یہ فرق خفیہ اور ذاتی ڈیٹا کے لیے لانڈری لوپ کا کام کرتا ہے، اور ایک تجارتی راز کی چوری کا راستہ بن جاتا ہے جس پر کسی کی نظر نہیں ہوتی۔ اس کا نقصان بھی بھاری ہے: IBM کے مطابق ہر پانچ میں سے ایک ادارے کو شیڈو AI کی وجہ سے ڈیٹا کی خلاف ورزی کا سامنا کرنا پڑا، اور ضرورت سے زیادہ شیڈو AI نے لاگت میں $670,000 کا اضافہ کیا۔
پالیسی ڈیٹا کے افشا کو کیوں نہیں روک سکتی
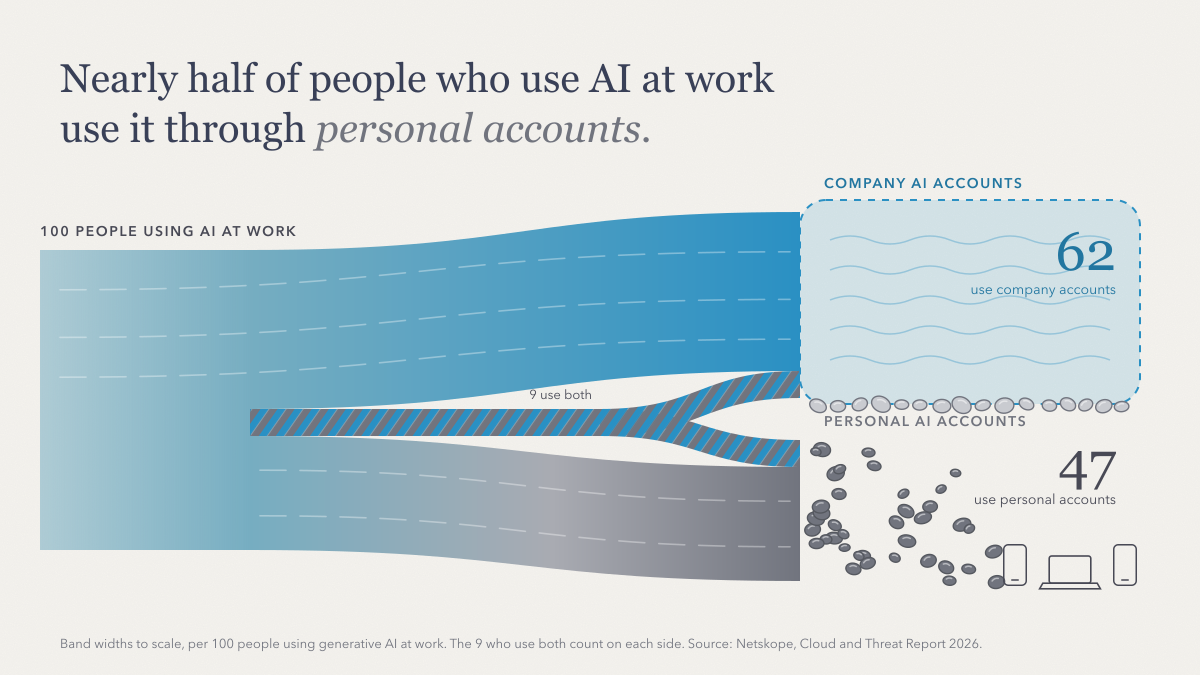
Netskope کے مطابق کام پر جنریٹو AI استعمال کرنے والے 47% لوگ ذاتی AI ایپس کا استعمال کرتے ہیں، جبکہ دس میں سے نو ادارے پہلے ہی کم از کم ایک AI ایپ کو بلاک کر چکے ہیں۔ یہ پھر بھی ہوتا ہے، کیونکہ منظور شدہ ٹول میں ایک چیز کی کمی ہوتی ہے: وہ ماڈل جسے صارف ترجیح دیتا ہے، یا اس فائل، ریپوزٹری یا سسٹم تک رسائی جس پر کام منحصر ہوتا ہے۔ AI کے لیے ادائیگی کرنے والی کمپنیوں کے Zapier کے سروے میں، ذاتی اکاؤنٹ استعمال کرنے والے 53% صارفین نے اپنے ٹولز کو ترجیح دی، اور 33% نے کہا کہ کمپنی کے ٹولز ان کی ضروریات پر پورے نہیں اترتے۔ بلاک کرنے سے ڈیٹا پیسٹ کرنے کا عمل بس فون پر منتقل ہو جاتا ہے۔
لانڈری لوپ کو کیا چیز ختم کرتی ہے
میرے خیال میں یہ لیبز کوئی ولن نہیں ہیں۔ یہ درمیانی راستہ تقریباً ہر ایک کے لیے فائدہ مند ہے: ملازمین کام مکمل کرتے ہیں، آجروں کو نتائج ملتے ہیں، اور لیبز کو ڈیٹا ملتا ہے۔ اس معاہدے سے غائب صرف وہی فریق ہے جو اس کا اصل مالک ہے۔
اس مسئلے کو ایک ایسا منظور شدہ ٹول ہی ختم کر سکتا ہے جسے لوگ بہرحال خود منتخب کرنا چاہیں۔ اسی لیے میں نے Caiioo بنایا ہے۔
یہ ہر معروف ماڈل، اور آپ کے اپنے ہارڈویئر پر اوپن ماڈلز چلاتا ہے۔ ماڈل تبدیل کرنا کار کا انجن بدلنے جیسا ہے: آپ کی بات چیت، فائلیں اور سیٹنگز اپنی جگہ برقرار رہتی ہیں۔
یہ AI کو آپ کے کام تک لاتا ہے۔ فائلز، میل اور کیلنڈرز آپ کی اپنی ڈیوائس سے ہی قابلِ رسائی ہوتے ہیں، کسی دوسرے کلاؤڈ پر اپلوڈ نہیں ہوتے، اور گفتگو اینڈ ٹو اینڈ اینکرپٹڈ طور پر سنک ہوتی ہے، تاکہ صرف آپ کی ڈیوائسز ہی انہیں پڑھ سکیں۔
اور یہ دکھاتا ہے کہ ہر درخواست کہاں جا رہی ہے۔ ٹرسٹ باؤنڈری ان تمام AI کمپنیوں کی فہرست پیش کرتی ہے جو آپ کا ڈیٹا وصول کرتی ہیں اور ان کی شرائط کیا اجازت دیتی ہیں، اور صرف ایک سوئچ کے ذریعے آپ کسی بھی ایسے فراہم کنندہ کو مسترد کر سکتے ہیں جو اس پر ٹریننگ کر سکتا ہو۔ ہم اسی قسم کے کنٹرولز بنا رہے ہیں تاکہ کوئی کمپنی اپنی کاغذی پالیسی کو ایسے قواعد میں تبدیل کر سکے جو ہر ایک پر لاگو ہوں۔
میں نے Caiioo کی شروعات اس لیے کی کیونکہ میں صلاحیت، خودمختاری اور تحفظ کو اہمیت دیتا ہوں۔ میں کسی ایک فاتح کو نہیں چننا چاہتا یا کسی ایک AI کمپنی پر منحصر نہیں رہنا چاہتا؛ اختیارات کا ارتکاز پہلے ہی بہت زیادہ ہے۔ کمپنیوں کو ان ٹولز کو استعمال کرنے، اپنے ڈیٹا کی حفاظت کرنے، اور خود مختار رہنے کی ضرورت ہے۔