本文档由英文原版机器翻译而成。如果翻译版本与英文原版之间存在任何冲突,请以英文原版为准。 阅读英文原版
庞大的个人数据训练管道
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
周四下午 4:40。公司批准的助手已达额度上限、不是她审阅合同信任的模型,或是无法访问存放合同的网盘。截止时间没有推迟,而她又被期望成为“AI 原生代”。于是,她把合同粘贴进了自己的个人 ChatGPT,三十秒后,便得到了通俗易懂的解读和决策。
在这个故事中,没有人认为有任何信息泄露,这完全是对 AI 合理合情的使用。但我认为,这是整个行业中最大规模的数据管道,而它仅仅依托于服务条款中不起眼的寥寥数字在运转。
两套规则
OpenAI 默认不会使用企业客户的数据进行训练,但对于使用 ChatGPT 的个人用户,它“可能会使用您的内容来训练我们的模型”。Anthropic 则在“开启此设置时”使用消费端聊天记录进行训练;商业及 API 使用则不受此限。在欧洲以外地区,Google 的免费开发者 API 会使用接收到的数据进行训练;付费版本则不会。xAI 做得更彻底:在欧盟和英国以外的部分地区,如果您在未登录状态下使用 Grok,您根本无法选择退出训练。
面向消费端的前提看似很清晰:谁输入,谁就拥有输入内容的所有权,并且同意分享该内容。OpenAI 的条款要求用户“陈述并保证”他们完全有权提供这些内容。
问题在于,这份合同属于雇主的机密信息,其中的姓名则是客户的个人数据。双方都未对此给予任何许可,而现在这些数据已被牢牢黏在云端的数据留存“捕蝇纸”上。对裁员的恐惧、对更快速交付成果的期望,以及展现“AI 原生”形象的压力,共同催生了一场系统性、持续性的技术数据泄露:这既辜负了客户的信任,也违反了明文规定的公司政策。
“洗白”闭环
在消费端条款下,她粘贴的内容、处理过程以及得出的结论,都可以成为训练数据。当她的公司日后购买企业版时,这些被抹去出处、被当作创意碎料板重新利用的学习成果,又被按席位卖回给公司。个人条款与商业条款之间的分野,实质上构成了机密与个人数据的洗白闭环,也是一个无人关注的商业机密泄露途径。代价同样高昂:IBM 发现,每五家组织中就有一家因影子 AI(Shadow AI)而遭遇泄露,严重的影子 AI 使损失增加了 670,000 美元。
为什么出台政策无法堵住泄露
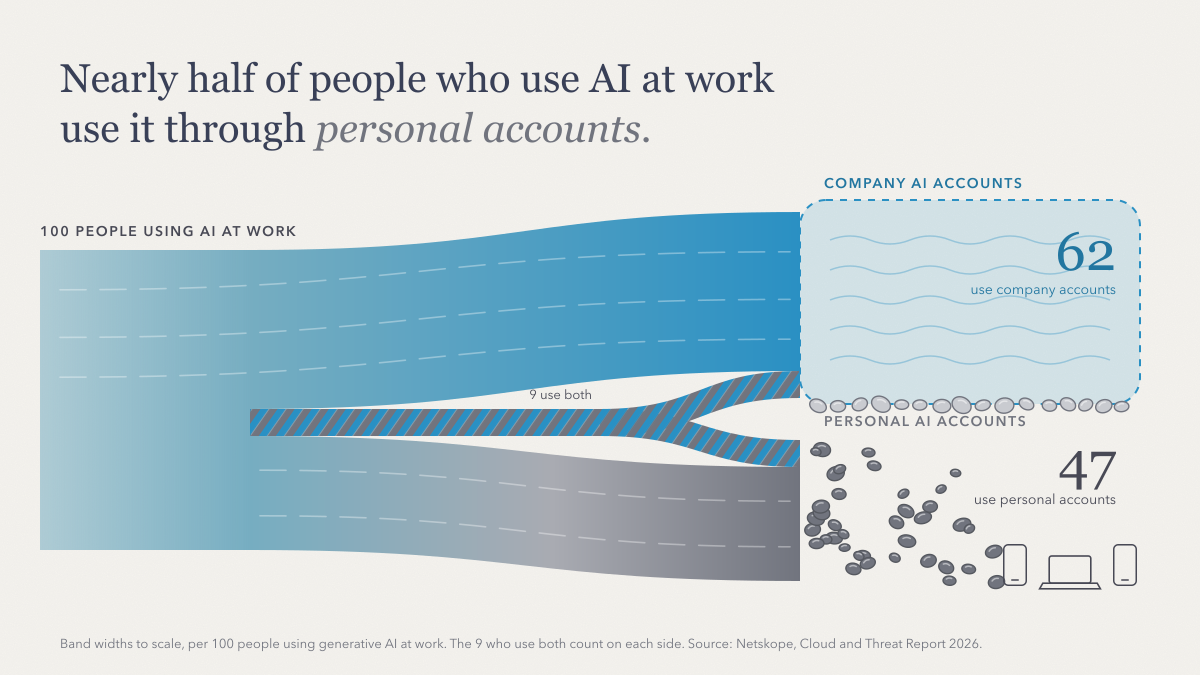
Netskope 发现,在工作中使用生成式 AI 的人中,有 47% 使用个人 AI 应用,而十分之九的组织已经封禁了至少一款 AI 应用。但这种情况依然在发生,因为获批的工具往往缺少关键要素:员工更青睐的模型,或是访问工作所依赖的文件、代码库或系统的权限。在 Zapier 针对付费使用 AI 的企业所做的调查中,53% 使用个人账户的用户更喜欢自己的工具,33% 表示公司的工具无法满足需求。封禁不过是把粘贴操作转移到了手机上。
如何终结“洗白”闭环
我不认为那些 AI 实验室是反派。这种灰色地带几乎对所有人都有利:员工完成了工作,雇主得到了成果,实验室获得了数据。这场交易中唯一缺席的,是数据真正的主人。
终结这一循环的,是一款人们即便有选择也依然会使用的合规工具。这就是我创建 Caiioo 的原因。
它能运行所有主流前沿模型,并在你自己的硬件上运行开源模型。切换模型就像给汽车换发动机:你的对话、文件和设置都会完好保留在原地。
它把 AI 融入你的工作流程中。文件、邮件和日历都可以直接从你自己的设备访问,而无需上传到又一个云端,并且对话同步经过端到端加密,只有你的设备能够读取。
它还会展示每个请求的去向。“信任边界”(Trust Boundary)列出了接收你数据的 AI 公司以及它们的条款权限,只需一个开关,就能拒绝任何可能将数据用于训练的提供商。我们正在构建相同的管控能力,让企业能够将纸面政策转化为对所有人都适用的切实规则。
我创立 Caiioo 是因为我看重能力、自主权与安全性。我不想押注某个单一赢家,也不想依赖某一家 AI 公司;权力的集中已经过于严重。企业既需要使用这些工具,也必须保护好自己的数据并保持独立。