Dies ist eine maschinelle Übersetzung des englischen Originaldokuments. Im Falle von Widersprüchen zwischen dieser Übersetzung und der englischen Originalversion ist die englische Version maßgeblich. Englische Originalversion lesen
Die große Trainingspipeline für persönliche Daten
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
Es ist Donnerstag, 16:40 Uhr. Der freigegebene Assistent hat sein Limit erreicht, ist nicht das Modell, dem sie bei Verträgen vertraut, oder kann nicht auf das Laufwerk zugreifen, auf dem der Vertrag liegt. Die Frist bleibt bestehen, und von ihr wird erwartet, „AI Native“ zu sein. Also fügt sie den Vertrag in ihr persönliches ChatGPT ein und erhält dreißig Sekunden später eine verständliche Zusammenfassung sowie eine Entscheidung.
Niemand in dieser Geschichte glaubt, dass etwas durchgesickert sei, und es ist ein vollkommen nachvollziehbarer Einsatz von KI. Ich halte es für die größte Datenpipeline der Branche – und sie verläuft über ein paar unscheinbare Worte in den Nutzungsbedingungen.
Zwei Regelwerke
OpenAI trainiert standardmäßig nicht mit Daten von Geschäftskunden, aber für Einzelpersonen, die ChatGPT nutzen, „dürfen Ihre Inhalte verwendet werden, um unsere Modelle zu trainieren.“ Anthropic trainiert mit Chats von Verbrauchern, „wenn diese Einstellung aktiviert ist“; die geschäftliche und API-Nutzung ist davon ausgenommen. Außerhalb Europas trainiert Googles kostenlose Entwickler-API mit dem, was sie empfängt; die kostenpflichtige tut dies nicht. xAI geht noch weiter: In einigen Regionen außerhalb der EU und des Vereinigten Königreichs können Sie dem Training überhaupt nicht widersprechen, wenn Sie Grok ohne Anmeldung nutzen.
Die Verbraucherseite beruht auf einer einfachen Prämisse: Wer tippt, besitzt das, was er tippt, und hat zugestimmt, es zu teilen. In den Nutzungsbedingungen von OpenAI müssen Nutzer „zusichern und gewährleisten“, dass sie jedes Recht haben, dies bereitzustellen.
Das Problem ist, dass der Vertrag eine vertrauliche Information ihres Arbeitgebers ist und die darin enthaltenen Namen personenbezogene Daten eines Kunden sind. Keine der Parteien hat etwas genehmigt, und nun klebt es am großen Fliegenfänger der Datenaufbewahrung in der Cloud. Die Angst vor Kündigungen, die Erwartung schnellerer Bearbeitungszeiten und der Druck, „AI Native“ zu wirken, haben zu einer systematischen, ständigen technischen Datenschutzverletzung geführt: einer Verletzung des Kundenvertrauens und schriftlicher Unternehmensrichtlinien.
Der Datenwäsche-Kreislauf
Unter den Verbraucherbedingungen können die eingefügten Inhalte, die Art und Weise der Bearbeitung und die gezogenen Schlüsse zu Trainingsdaten werden. Wenn ihr Unternehmen später die Enterprise-Version kauft, erhält es diese Erkenntnisse zurück – mit reingewaschener Quelle, wiederverwertet als Ideen-Spanplatte und abgerechnet pro Nutzerlizenz. Die Trennung zwischen privaten und geschäftlichen Bedingungen ist ein Datenwäsche-Kreislauf für vertrauliche und personenbezogene Daten sowie ein Einfallstor für den Verlust von Geschäftsgeheimnissen, das niemand im Blick hat. Und es kostet Geld: Laut IBM verzeichnete jedes fünfte Unternehmen eine Datenpanne durch Schatten-KI, und eine intensive Nutzung von Schatten-KI trieb die Kosten um 670.000 US-Dollar in die Höhe.
Warum eine Richtlinie das Datenleck nicht stoppt
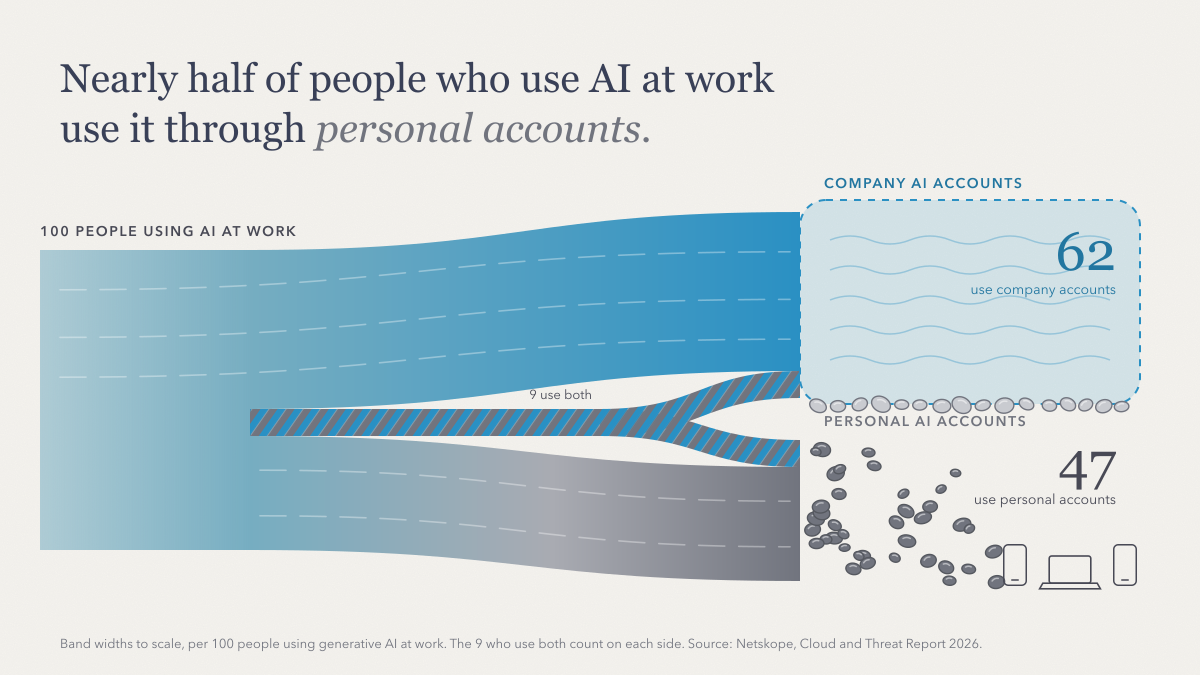
Netskope stellt fest, dass 47 % der Menschen, die generative KI am Arbeitsplatz nutzen, private KI-Apps verwenden, während neun von zehn Unternehmen bereits mindestens eine KI-App blockieren. Es geschieht trotzdem, weil dem freigegebenen Tool eines fehlt: das bevorzugte Modell oder der Zugriff auf die Datei, das Repository oder das System, von dem die Arbeit abhängt. In einer Umfrage von Zapier unter Unternehmen, die für KI bezahlen, zogen 53 % der Nutzer privater Konten ihre eigenen Tools vor, und 33 % gaben an, dass die Unternehmenstools ihren Anforderungen nicht entsprachen. Blockieren verlagert das Einfügen lediglich auf das Smartphone.
Was den Datenwäsche-Kreislauf schließt
Ich glaube nicht, dass die KI-Labore die Bösewichte sind. Die Grauzone kommt fast allen gelegen: Mitarbeiter erledigen ihre Arbeit, Arbeitgeber erhalten die Ergebnisse, Labore bekommen die Daten. Die einzige Partei, die bei diesem Deal zu kurz kommt, ist diejenige, der die Daten gehören.
Was sie schließt, ist ein freigegebenes Tool, das man ohnehin freiwillig wählen würde. Genau deshalb habe ich Caiioo entwickelt.
Es führt jedes führende Modell aus sowie Open-Source-Modelle auf Ihrer eigenen Hardware. Der Wechsel von Modellen ist wie der Motortausch in einem Auto: Ihre Unterhaltungen, Dateien und Einstellungen bleiben an Ort und Stelle.
Es bringt die KI zu Ihrer Arbeit. Auf Dateien, E-Mails und Kalender wird von Ihrem eigenen Gerät aus zugegriffen, anstatt sie in eine weitere Cloud hochzuladen, und Unterhaltungen werden Ende-zu-Ende-verschlüsselt synchronisiert, sodass nur Ihre Geräte sie lesen können.
Und es zeigt, wohin jede Anfrage geht. Die Trust Boundary listet auf, welche KI-Unternehmen Ihre Daten erhalten und was deren Bedingungen erlauben – und ein einziger Schalter schließt jeden Anbieter aus, der damit trainieren könnte. Wir entwickeln dieselben Steuerungsmöglichkeiten, damit ein Unternehmen seine Richtlinien auf dem Papier in verbindliche Regeln für alle verwandeln kann.
Ich habe Caiioo gestartet, weil mir Leistungsfähigkeit, Autonomie und Sicherheit wichtig sind. Ich möchte mich weder auf einen Gewinner festlegen noch von einem einzigen KI-Unternehmen abhängig sein; es gibt bereits zu viel Machtkonzentration. Unternehmen müssen diese Werkzeuge nutzen können, ihre Daten schützen und unabhängig bleiben.