यह मूल अंग्रेजी दस्तावेज़ का मशीन अनुवाद है। इस अनुवाद और मूल अंग्रेजी संस्करण के बीच किसी भी विवाद की स्थिति में, अंग्रेजी संस्करण ही मान्य होगा। मूल अंग्रेजी संस्करण पढ़ें
व्यक्तिगत डेटा की विशाल ट्रेनिंग पाइपलाइन
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
गुरुवार के शाम के 4:40 बजे हैं। स्वीकृत असिस्टेंट अपनी सीमा समाप्त कर चुका है, यह वह मॉडल नहीं है जिस पर अनुबंधों के लिए वह भरोसा करती है, या उस ड्राइव तक नहीं पहुँच सकता जहाँ अनुबंध मौजूद है। समय-सीमा आगे नहीं बढ़ी है, और उससे "AI Native" होने की अपेक्षा की जाती है। इसलिए वह अनुबंध को अपने व्यक्तिगत ChatGPT में पेस्ट करती है और तीस सेकंड बाद, उसके पास एक सरल व्याख्या और एक निर्णय मौजूद होता है।
उस कहानी में किसी को नहीं लगता कि कुछ लीक हुआ है, और यह AI का पूरी तरह से उचित उपयोग है। मेरा मानना है कि यह उद्योग की सबसे बड़ी डेटा पाइपलाइन है, और यह सेवा की शर्तों के कुछ छोटे शब्दों के माध्यम से संचालित होती है।
दो नियम-पुस्तिकाएं
OpenAI डिफ़ॉल्ट रूप से व्यावसायिक ग्राहकों के डेटा पर ट्रेन नहीं करता है, लेकिन ChatGPT का उपयोग करने वाले व्यक्तिगत उपयोगकर्ताओं के लिए यह "हमारे मॉडल को प्रशिक्षित करने के लिए आपकी सामग्री का उपयोग कर सकता है।" Anthropic उपभोक्ता चैट पर ट्रेन करता है "जब यह सेटिंग चालू होती है"; व्यावसायिक और API उपयोग को इससे छूट प्राप्त है। यूरोप के बाहर, Google का मुफ़्त डेवलपर API जो डेटा प्राप्त करता है उस पर ट्रेन करता है; पेड API ऐसा नहीं करता है। xAI इससे भी एक कदम आगे जाता है: EU और UK के बाहर कुछ क्षेत्रों में, यदि आप लॉग इन किए बिना Grok का उपयोग करते हैं, तो आप ट्रेनिंग से बिल्कुल भी ऑप्ट-आउट नहीं कर सकते।
उपभोक्ता पक्ष एक स्पष्ट आधार पर टिका है: जो व्यक्ति टाइप करता है, वह उस सामग्री का मालिक है और उसने इसे साझा करने की सहमति दी है। OpenAI की शर्तें उपयोगकर्ताओं से "यह घोषणा और वारंटी देने" की अपेक्षा करती हैं कि उनके पास इसे उपलब्ध कराने का पूरा अधिकार है।
समस्या यह है कि वह अनुबंध उसके नियोक्ता की गोपनीय जानकारी है, और उसमें मौजूद नाम किसी ग्राहक का व्यक्तिगत डेटा हैं। किसी ने भी किसी चीज़ की मंज़ूरी नहीं दी थी, और अब यह क्लाउड के विशाल रिटेंशन फ़्लाईपेपर पर चिपक चुका है। छंटनी का डर, काम को तेज़ी से पूरा करने की उम्मीदें और "AI Native" दिखने के दबाव ने एक व्यवस्थित, निरंतर तकनीकी डेटा उल्लंघन को जन्म दिया है: ग्राहकों के विश्वास और कंपनी की लिखित नीति का खुला उल्लंघन।
लॉन्ड्री लूप
उपभोक्ता शर्तों के तहत, उसने जो पेस्ट किया, उसने जिस तरह से उस पर काम किया और जो निष्कर्ष निकाला, वह सब ट्रेनिंग डेटा बन सकता है। जब उसकी कंपनी बाद में इसका एंटरप्राइज़ संस्करण खरीदती है, तो उसे वही ज्ञान स्रोत मिटाकर, विचार पार्टिकल बोर्ड के रूप में पुन: उपयोग करके और प्रति सीट के हिसाब से बेचा जाता है। व्यक्तिगत और व्यावसायिक शर्तों के बीच का यह बँटवारा गोपनीय और व्यक्तिगत डेटा के लिए एक लॉन्ड्री लूप है, और एक ऐसा ट्रेड सीक्रेट वेक्टर है जिस पर किसी का ध्यान नहीं है। इसका भारी नुकसान भी होता है: IBM ने पाया कि पाँच में से एक संगठन में शैडो AI के कारण डेटा ब्रीच हुआ, और अत्यधिक शैडो AI उपयोग ने बिल में $670,000 की अतिरिक्त लागत जोड़ दी।
केवल नीति डेटा लीक को क्यों नहीं रोक पाएगी
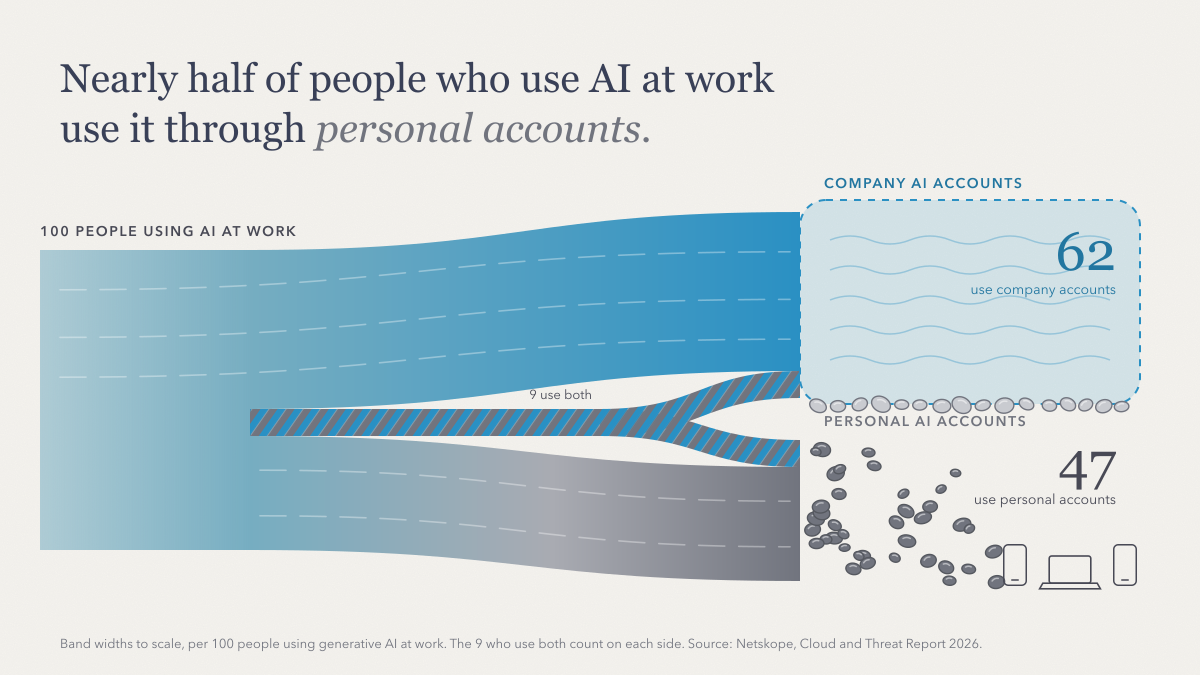
Netskope के अनुसार काम पर जनरेटिव AI का उपयोग करने वाले 47% लोग व्यक्तिगत AI ऐप्स का उपयोग करते हैं, जबकि दस में से नौ संगठन पहले से ही कम से कम एक AI ऐप को ब्लॉक करते हैं। फिर भी ऐसा होता है, क्योंकि स्वीकृत टूल में एक चीज़ की कमी होती है: वह मॉडल जिसे उपयोगकर्ता पसंद करता है, या उस फ़ाइल, रिपॉजिटरी या सिस्टम तक पहुँच जिस पर काम निर्भर करता है। AI के लिए भुगतान करने वाली कंपनियों के Zapier के सर्वेक्षण में, व्यक्तिगत खाता उपयोगकर्ताओं में से 53% ने अपने स्वयं के टूल को प्राथमिकता दी, और 33% ने कहा कि कंपनी का टूल उनकी ज़रूरतों के अनुकूल नहीं था। ब्लॉक करने से केवल इतना होता है कि डेटा को फोन पर पेस्ट किया जाने लगता है।
लॉन्ड्री लूप को क्या रोकता है
मुझे नहीं लगता कि लैब्स खलनायक हैं। यह ग्रे एरिया लगभग सभी के अनुकूल बैठता है: कर्मचारी काम पूरा करते हैं, नियोक्ताओं को आउटपुट मिलता है, और लैब्स को डेटा मिलता है। इस सौदे में केवल वही पक्ष नदारद है जिसका वास्तव में उस पर अधिकार है।
जो चीज़ इसे रोकती है वह है एक ऐसा स्वीकृत टूल जिसे लोग वैसे भी चुनना पसंद करेंगे। इसीलिए मैंने Caiioo बनाया।
यह हर अग्रणी मॉडल, और आपके अपने हार्डवेयर पर ओपन मॉडल चलाता है। मॉडल बदलना कार के इंजन को बदलने जैसा है: आपकी बातचीत, फ़ाइलें और सेटिंग्स जस की तस बनी रहती हैं।
यह AI को आपके काम तक लाता है। फ़ाइलें, मेल और कैलेंडर आपके अपने डिवाइस से एक्सेस किए जाते हैं, किसी अन्य क्लाउड पर अपलोड नहीं किए जाते, और बातचीत एंड-टू-एंड एन्क्रिप्टेड सिंक होती है, ताकि केवल आपके डिवाइस ही उन्हें पढ़ सकें।
और यह दिखाता है कि प्रत्येक अनुरोध कहाँ जाता है। Trust Boundary उन AI कंपनियों को सूचीबद्ध करती है जो आपका डेटा प्राप्त करती हैं और उनकी शर्तें क्या अनुमति देती हैं, और एक अकेला स्विच किसी भी ऐसे प्रदाता को अस्वीकार कर देता है जो इस पर ट्रेनिंग कर सकता है। हम ऐसे ही नियंत्रण बना रहे हैं ताकि कोई भी कंपनी अपनी कागज़ी नीति को ऐसे नियमों में बदल सके जो सभी पर समान रूप से लागू हों।
मैंने Caiioo की शुरुआत इसलिए की क्योंकि मैं क्षमता, स्वायत्तता और सुरक्षा को महत्व देता हूँ। मैं किसी एक विजेता को नहीं चुनना चाहता या किसी एक AI कंपनी पर निर्भर नहीं रहना चाहता; पहले से ही सत्ता का अत्यधिक संकेंद्रण है। कंपनियों को इन टूल्स का उपयोग करने, अपने डेटा की सुरक्षा करने और स्वतंत्र बने रहने की आवश्यकता है।