Данный документ является машинным переводом оригинальной английской версии. В случае любых расхождений между переводом и оригиналом на английском языке, приоритет имеет английская версия. Читать оригинал на английском языке
Великий конвейер обучения на персональных данных
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
Четверг, 16:40. Одобренный корпоративный ассистент исчерпал лимиты, не подходит для анализа договоров или не имеет доступа к диску, где лежит документ. Дедлайн никто не отменял, а от сотрудницы ждут владения подходом «AI Native». Поэтому она копирует договор в свой личный ChatGPT и уже через тридцать секунд получает понятный разбор и готовое решение.
Никто в этой истории не думает, что произошла утечка, и со стороны это выглядит как вполне разумное применение ИИ. Но я считаю, что это крупнейший конвейер передачи данных в индустрии, и работает он за счет пары незаметных фраз в условиях обслуживания.
Два свода правил
OpenAI по умолчанию не обучается на данных корпоративных клиентов, но для индивидуальных пользователей ChatGPT компания «может использовать ваш контент для обучения наших моделей». Anthropic обучается на чатах обычных пользователей, «когда эта настройка включена»; корпоративное использование и API от этого освобождены. За пределами Европы бесплатный API для разработчиков от Google обучается на получаемых данных; платный — нет. xAI идёт ещё дальше: в некоторых регионах за пределами ЕС и Великобритании при использовании Grok без входа в систему отказаться от обучения вообще невозможно.
Потребительская сторона опирается на простую предпосылку: тот, кто вводит текст, владеет тем, что печатает, и согласился этим поделиться. Согласно условиям OpenAI, пользователи «заявляют и гарантируют», что обладают всеми правами на предоставление этих данных.
Проблема в том, что договор является конфиденциальной информацией работодателя, а указанные в нём имена — персональными данными клиента. Никто из них не давал согласия, и теперь всё это прилипло к гигантской облачной липучке для хранения данных. Страх увольнений, требования ускорить выполнение задач и давление казаться «AI Native» породили систематическую и непрерывную техническую утечку данных — нарушение доверия клиентов и официальной политики компании.
Круговорот «отмывания» данных
В рамках пользовательских условий скопированный текст, логика работы с ним и полученные выводы — всё это может стать материалом для обучения моделей. Когда компания впоследствии покупает корпоративную версию, она получает этот опыт обратно, но уже с «отмытым» источником — спрессованным, как плита ДСП из чужих идей, и продаваемым с оплатой за каждое рабочее место. Разделение условий на личные и коммерческие превратилось в конвейер «отмывания» конфиденциальных и персональных данных, а также в канал утечки коммерческой тайны, за которым никто не следит. И это стоит денег: по данным IBM, каждая пятая организация столкнулась с утечкой из-за теневого ИИ, а активное несанкционированное использование ИИ добавило к ущербу в среднем 670 000 долларов.
Почему регламенты не остановят утечку
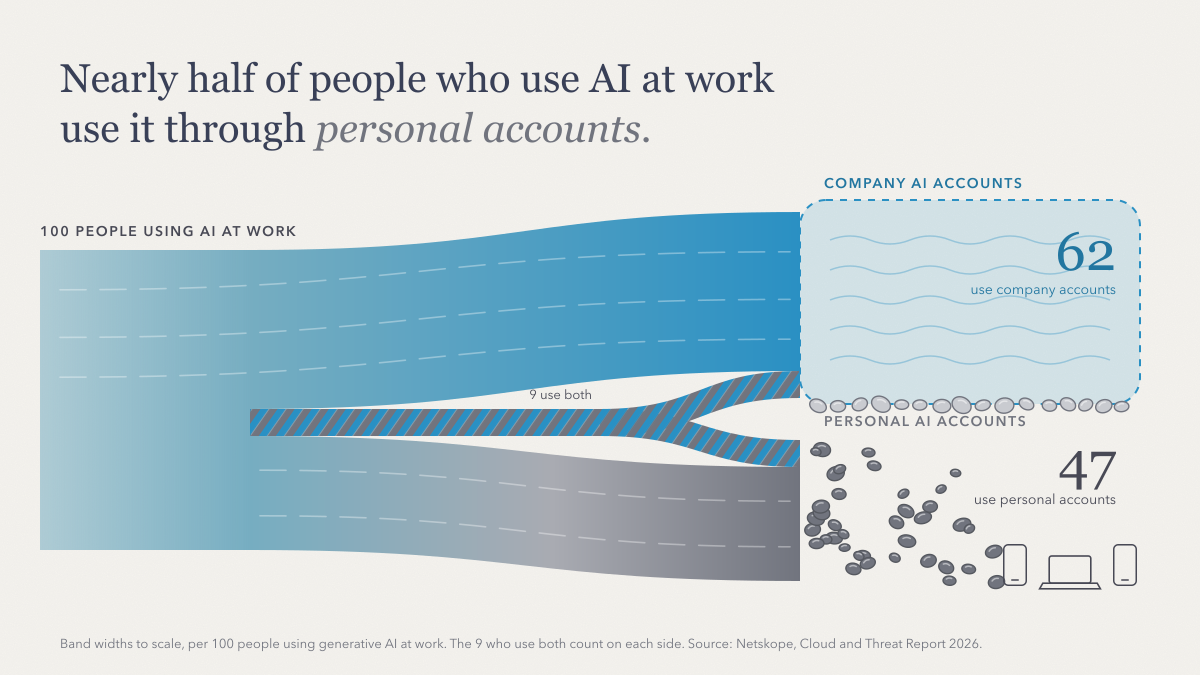
Исследование Netskope показывает, что 47% людей, использующих генеративный ИИ на работе, пользуются личными сервисами, хотя девять из десяти организаций уже блокируют как минимум одно ИИ-приложение. Это все равно происходит, потому что в одобренном инструменте не хватает одной детали: нужной человеку модели или прямого доступа к файлу, репозиторию или рабочей системе. По данным опроса Zapier среди компаний, оплачивающих ИИ, 53% пользователей личных аккаунтов предпочитают собственные инструменты, а 33% заявили, что корпоративные решения не удовлетворяют их требованиям. Блокировки лишь приводят к тому, что текст копируют через телефон.
Как разорвать этот круг
Я не считаю исследовательские лаборатории злодеями. Серая зона удобна практически всем: сотрудники закрывают задачи, работодатели получают результат, лаборатории получают обучающие данные. Единственная сторона, которую забыли спросить в этой сделке, — фактический владелец данных.
Разорвать этот замкнутый круг может только официально одобренный инструмент, который сотрудники выбрали бы сами. Именно для этого я создал Caiioo.
Он работает со всеми передовыми моделями, а также с открытыми моделями прямо на вашем оборудовании. Переключение моделей похоже на замену двигателя в автомобиле: ваши диалоги, файлы и настройки остаются на своих местах.
Он доставляет ИИ к вашей непосредственной работе. Файлы, почта и календари обрабатываются прямо с вашего устройства, а не выгружаются в очередное стороннее облако, при этом переписка синхронизируется со сквозным шифрованием, поэтому прочитать ее могут только ваши устройства.
И он прозрачно показывает путь каждого запроса. Функция «Граница доверия» (Trust Boundary) перечисляет, какие ИИ-компании получают ваши данные и что позволяют их условия обслуживания, а один переключатель позволяет заблокировать любого провайдера, который может обучаться на них. Мы создаем такие же средства контроля для компаний, чтобы они могли превратить бумажные регламенты в действенные технические правила для всей команды.
Я основал Caiioo, потому что ценю функциональность, автономию и безопасность. Я не хочу делать ставку на одного игрока или зависеть от одной ИИ-компании: консолидация контроля в этой сфере уже и так чрезмерна. Компаниям необходимо использовать эти инструменты, надежно защищать свои данные и сохранять независимость.