Detta är en maskinöversättning av det engelska originaldokumentet. Vid eventuella avvikelser mellan denna översättning och den engelska originalversionen ska den engelska versionen ha företräde. Läs den engelska originalversionen
Den stora träningspipelinen för personuppgifter
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
Klockan är 16:40 en torsdag. Den godkända assistenten har nått sin gräns, är inte den modell hon litar på för avtal, eller kommer inte åt enheten där avtalet ligger. Deadlinen har inte flyttats, och hon förväntas vara "AI Native". Så hon klistrar in avtalet i sitt privata ChatGPT och har trettio sekunder senare en lättbegriplig sammanfattning och ett beslut.
Ingen i den berättelsen tror att något har läckt, och det är en helt rimlig användning av AI. Jag tror att det är branschens största datapipeline, och den drivs genom några få små ord i användarvillkoren.
Två regelverk
OpenAI tränar som standard inte på företagskunders data, men för privatpersoner som använder ChatGPT "kan ditt innehåll användas för att träna våra modeller." Anthropic tränar på konsumentchattar "när denna inställning är på"; företags- och API-användning är undantagen. Utanför Europa tränar Googles kostnadsfria utvecklar-API på det som tas emot; den betalda versionen gör det inte. xAI går ännu längre: i vissa regioner utanför EU och Storbritannien kan du, om du använder Grok utan att logga in, inte välja bort träning över huvud taget.
Konsumentsidan vilar på en tydlig premiss: den som skriver äger det som skrivs och har gått med på att dela det. OpenAIs villkor kräver att användare "intygar och garanterar" att de har all rätt att tillhandahålla det.
Problemet är att avtalet är hennes arbetsgivares konfidentiella information, och namnen i det är en klients personuppgifter. Ingen av parterna har godkänt något, och nu sitter det fast på molnets stora flugpapper för datalagring. Rädsla för uppsägningar, förväntningar på snabbare handläggningstider och pressen att framstå som "AI Native" har lett till en systematisk, konstant teknisk dataläcka: ett brott mot kundens förtroende och mot företagets skriftliga policy.
Tvättloopen
Under konsumentvillkoren kan det hon klistrade in, hur hon arbetade med det och vad hon drog för slutsatser bli träningsdata. När hennes företag senare köper företagsversionen får det tillbaka dessa lärdomar med källan borttvättad, återanvänd som idé-spånskiva och såld per användarlicens. Uppdelningen mellan personliga och kommersiella villkor är en tvättloop för konfidentiell information och personuppgifter, och en vektor för affärshemligheter som ingen håller koll på. Det kostar också: IBM fann att en av fem organisationer råkade ut för en dataläcka orsakad av skugg-AI, och omfattande skugg-AI lade till 670 000 dollar på notan.
Varför en policy inte stoppar läckan
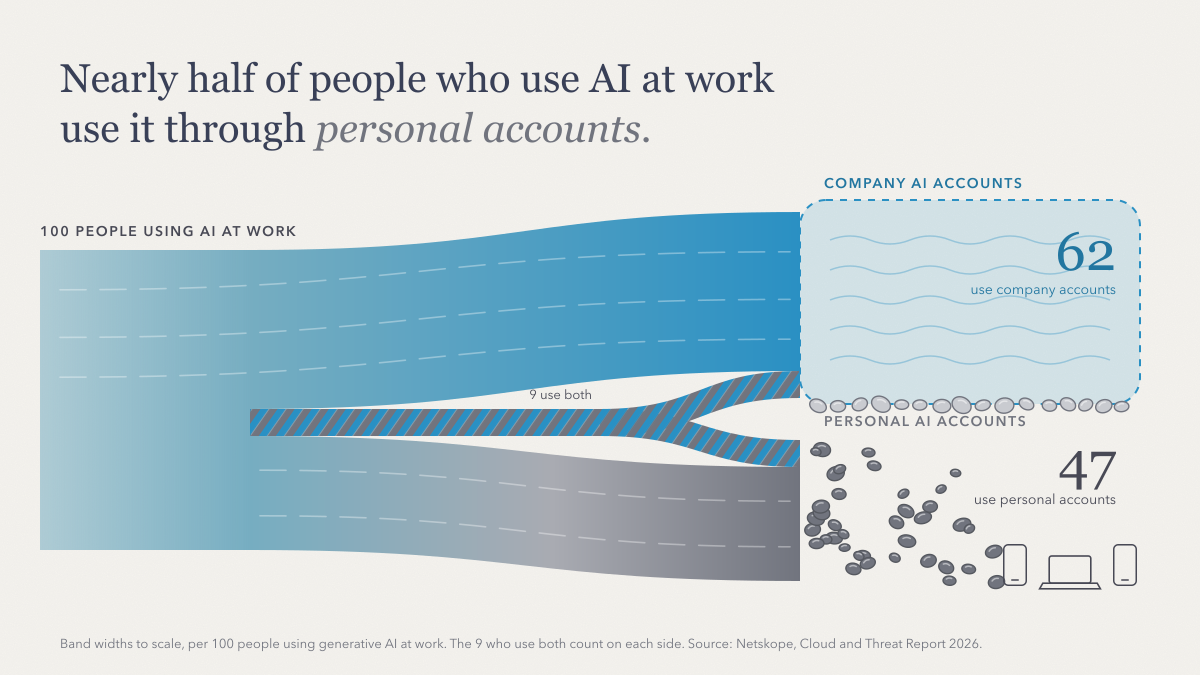
Netskope visar att 47 % av dem som använder generativ AI på jobbet använder privata AI-appar, samtidigt som nio av tio organisationer redan blockerar minst en AI-app. Det sker ändå, eftersom det godkända verktyget saknar en sak: modellen personen föredrar, eller åtkomst till filen, databasen eller systemet som arbetet är beroende av. I Zapiers undersökning bland företag som betalar för AI föredrog 53 % av användarna med privata konton sina egna verktyg, och 33 % uppgav att företagets verktyg inte passade deras behov. Att blockera flyttar bara inklistringen till en telefon.
Vad som sluter tvättloopen
Jag tror inte att AI-labben är några skurkar. Gråzonen passar nästan alla: de anställda slutför arbetet, arbetsgivarna får resultatet, labben får datan. Den enda parten som saknas i uppgörelsen är den som äger den.
Det som stänger den är ett godkänt verktyg som människor ändå skulle välja. Det är därför jag byggde Caiioo.
Det kör alla ledande modeller, och öppna modeller på din egen hårdvara. Att byta modeller är som att byta motor i en bil: dina konversationer, filer och inställningar ligger kvar.
Det tar AI till ditt arbete. Filer, e-post och kalendrar nås från din egen enhet i stället för att laddas upp till ytterligare ett moln, och konversationer synkroniseras end-to-end-krypterat, så att endast dina enheter kan läsa dem.
Och det visar vart varje förfrågan tar vägen. Trust Boundary listar vilka AI-företag som tar emot dina data och vad deras villkor tillåter, och ett enda reglage blockerar alla leverantörer som kan träna på den. Vi bygger samma kontroller så att ett företag kan omvandla sin papperspolicy till regler som gäller för alla.
Jag startade Caiioo för att jag värdesätter kapacitet, autonomi och säkerhet. Jag vill inte utse en vinnare eller vara beroende av ett enda AI-företag; det pågår redan alltför mycket maktkoncentration. Företag behöver använda dessa verktyg, skydda sina data och förbli oberoende.