本文件為英文原版的機器翻譯。若翻譯版本與英文原版之間存在任何歧義,概以英文原版為準。 閱讀英文原版
龐大的個人資料訓練管線
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
那是週四下午 4 點 40 分。公司核准的助理工具已達使用上限、不是她審閱合約時信任的模型,或者無法存取合約存放的雲端硬碟。截止時間沒有改變,而大家都期望她具備「AI 原生」的工作能力。於是,她將合約貼入個人的 ChatGPT,三十秒後,就得到白話易懂的分析與決策。
在這個故事中,沒有人認為有任何外洩情事,這也是完全合情合理的 AI 使用方式。但我認為,這是整個業界最大規模的資料管線,而它就運作在服務條款中那幾行微小的文字之上。
兩套規則
OpenAI 預設不會使用企業客戶的資料進行訓練,但對於使用 ChatGPT 的個人用戶,它「可能會使用您的內容來訓練我們的模型」。Anthropic 則「在此設定開啟時」使用消費者對話進行訓練;商業與 API 用戶則不受此限。在歐洲以外地區,Google 的免費開發者 API 會使用接收到的內容進行訓練;付費版本則不會。xAI 更是進一步:在歐盟和英國以外的某些地區,如果您在未登入的情況下使用 Grok,您甚至完全無法選擇退出訓練。
消費端建立在一個看似簡單的前提上:誰輸入,誰就擁有輸入的內容,並同意分享。OpenAI 的條款要求使用者「陳述並保證」他們擁有提供該內容的一切權利。
問題在於,那份合約是她雇主的機密資訊,而其中的姓名則是客戶的個人資料。雙方都未曾同意任何事,而現在這些資料就這樣黏在雲端巨大的資料留存捕蠅紙上。對裁員的恐懼、更快交付成果的期待,以及展現「AI 原生」形象的壓力,共同釀成了一場系統性且持續發生的技術性資料外洩:既違反了客戶信任,也違背了公司的書面政策。
洗白循環
在個人消費條款下,她貼上的內容、她的處理方式以及她得出的結論,全都可以成為訓練資料。日後當她的公司購買企業版時,公司購回了這些被洗去來源、重新拼湊成概念甘蔗板並按席次計費販售的學習成果。個人與商業條款之間的脫節,成了機密與個人資料的洗白循環,更是個無人看管的商業機密洩漏途徑。這代價也不容小覷:IBM 發現每五家企業中就有一家因影子 AI 導致資料外洩,而嚴重的影子 AI 更讓外洩成本增加了 670,000 美元。
為什麼政策無法阻止外洩
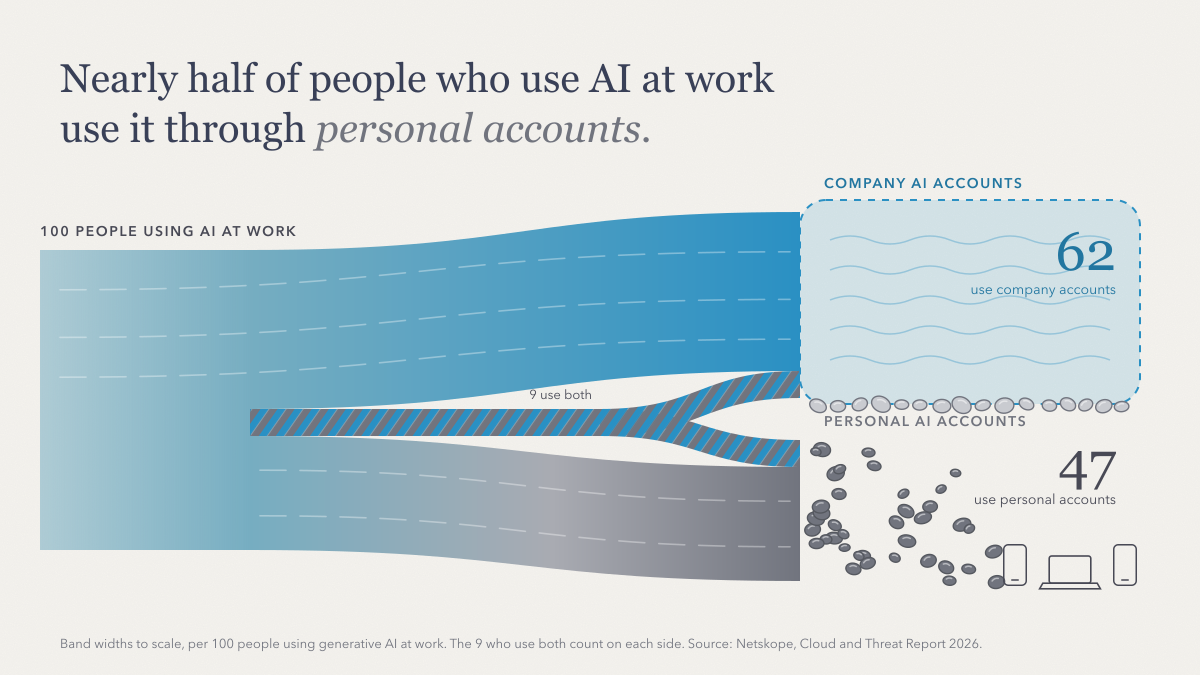
Netskope 發現,在工作中使用生成式 AI 的人中,有 47% 使用個人 AI 應用程式,儘管十家企業中有九家已經封鎖了至少一款 AI 應用程式。這種情況依然發生,是因為核准的工具缺少了一樣東西:該員工偏好的模型,或是存取工作所依賴的檔案、代碼庫或系統的權限。在 Zapier 針對付費購買 AI 服務之企業的調查中,53% 使用個人帳號的使用者更偏好自己的工具,33% 則表示公司的工具不符合需求。封鎖只是把貼上動作轉移到了手機上。
什麼才能終結這個洗白循環
我並不認為這些研究室是反派。這個灰色地帶幾乎迎合了所有人:員工完成了工作、雇主得到了產出、研究室得到了資料。這場交易中唯一缺席的,就是真正擁有這些資料的人。
能夠終結這一切的,是一款大家本來就會主動選擇的合規工具。這就是我打造 Caiioo 的原因。
它能運行所有頂尖模型,以及在您自己的硬體上運行開源模型。切換模型就像替汽車更換引擎:您的對話、檔案與設定都會完好保留。
它將 AI 帶入您的工作。檔案、郵件與行事曆直接從您自己的裝置存取,無需上傳至另一個雲端,對話更透過端對端加密同步,因此只有您的裝置才能讀取。
而且它能清楚顯示每個請求的去向。「信任邊界」列出了哪些 AI 公司接收了您的資料以及其條款許可的範圍,只要一個開關,就能拒絕任何可能使用資料進行訓練的供應商。我們也正在構建相同的控制功能,讓企業能將紙上政策轉化為對全員有效的規則。
我創立 Caiioo 是因為我重視能力、自主權與安全性。我不想押注單一贏家或依賴任何一家 AI 公司;權力過度集中的情況已經太嚴重了。企業需要運用這些工具、保護其資料,並維持獨立性。