Esta es una traducción automática del documento original en inglés. En caso de cualquier discrepancia entre esta traducción y la versión original en inglés, prevalecerá la versión en inglés. Leer la versión original en inglés
El gran flujo de entrenamiento con datos personales
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
Son las 16:40 de un jueves. El asistente aprobado ha alcanzado su límite, no es el modelo en el que ella confía para contratos o no puede acceder a la unidad donde se encuentra el contrato. La fecha límite no ha cambiado y se espera que sea "nativa de la IA". Así que pega el contrato en su ChatGPT personal y, treinta segundos después, tiene una lectura en lenguaje claro y una decisión.
Nadie en esa historia cree que se haya filtrado nada, y es un uso perfectamente razonable de la IA. Creo que es el mayor flujo de datos de la industria, y pasa por unas pocas palabras en los términos de servicio.
Dos conjuntos de reglas
OpenAI no entrena con los datos de clientes empresariales de forma predeterminada, pero para particulares que usan ChatGPT "puede utilizar su contenido para entrenar nuestros modelos". Anthropic entrena con los chats de consumidores "cuando esta opción está activada"; el uso empresarial y de API está exento. Fuera de Europa, la API gratuita para desarrolladores de Google entrena con lo que recibe; la versión de pago no lo hace. xAI va aún más lejos: en algunas regiones fuera de la UE y el Reino Unido, si usas Grok sin iniciar sesión, no puedes rechazar el entrenamiento de ninguna manera.
El lado del consumidor se basa en una premisa limpia: quien escribe es dueño de lo que escribe y aceptó compartirlo. Los términos de OpenAI exigen que los usuarios "declaren y garanticen" que tienen pleno derecho a facilitarlo.
El problema es que el contrato es información confidencial de su empleador y los nombres que figuran en él son datos personales de un cliente. Ninguno de los dos autorizó nada, y ahora ha quedado atrapado en el gran papel matamoscas de la retención de datos en la nube. El temor a los despidos, las expectativas de entregas más rápidas y la presión por parecer "nativos de la IA" han generado una brecha técnica de datos sistemática y constante: una violación de la confianza del cliente y de las políticas internas de la empresa.
El ciclo de lavado
Bajo los términos para consumidores, lo que pegó, cómo lo trabajó y lo que concluyó pueden convertirse en datos de entrenamiento. Cuando su empresa compra más tarde la versión corporativa, recupera ese aprendizaje con el origen borrado, reutilizado como aglomerado de ideas y vendido por usuario. La división entre términos personales y comerciales es un ciclo de lavado para datos confidenciales y personales, y una vía de fuga de secretos comerciales que nadie vigila. Además, cuesta dinero: IBM descubrió que una de cada cinco organizaciones sufrió una brecha provocada por la IA no autorizada («shadow AI»), y un uso intensivo de esta sumó 670 000 $ a la factura.
Por qué una política no detendrá la fuga
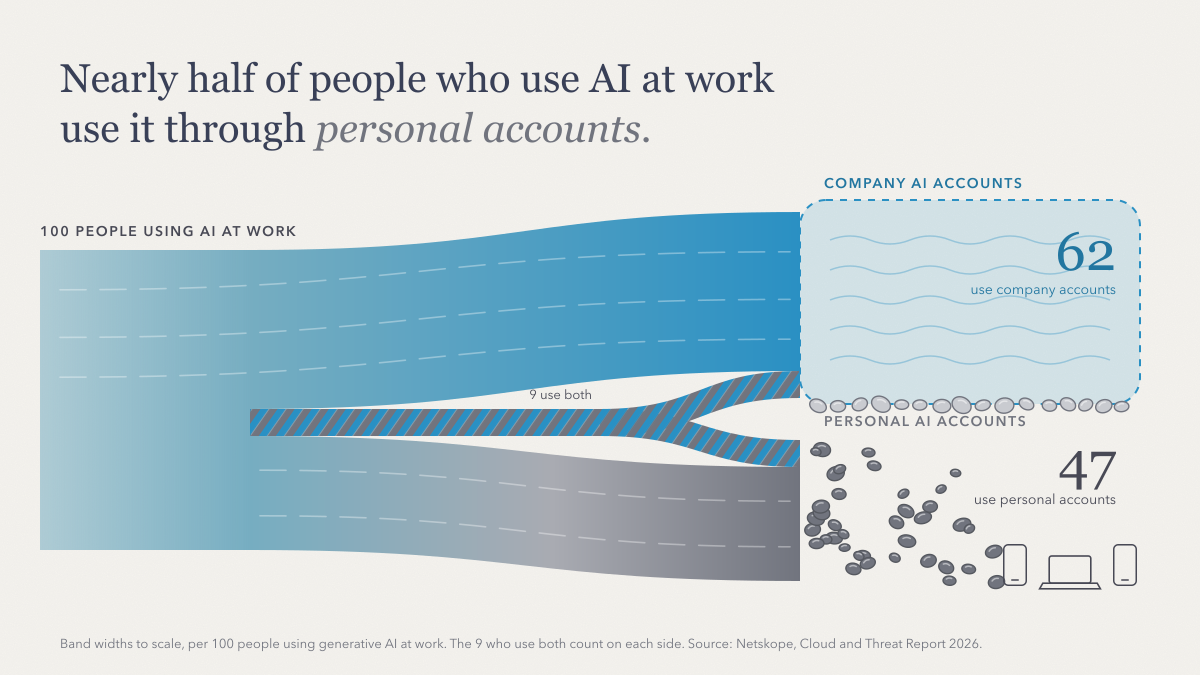
Netskope señala que el 47 % de las personas que utilizan IA generativa en el trabajo usan aplicaciones personales de IA, mientras que nueve de cada diez organizaciones ya bloquean al menos una app de IA. Ocurre de todos modos porque a la herramienta aprobada le falta una cosa: el modelo que la persona prefiere o el acceso al archivo, repositorio o sistema del que depende su trabajo. En la encuesta de Zapier a empresas que pagan por IA, el 53 % de los usuarios de cuentas personales prefirió sus propias herramientas y el 33 % afirmó que las de la empresa no se adaptaban a sus necesidades. Bloquearlas simplemente traslada el acto de pegar al móvil.
Qué cierra el ciclo de lavado
No creo que los laboratorios sean villanos. La zona gris le conviene a casi todo el mundo: los empleados terminan el trabajo, las empresas obtienen los resultados y los laboratorios obtienen los datos. La única parte ausente en este acuerdo es quien tiene la propiedad.
Lo que lo cierra es una herramienta aprobada que la gente elegiría de todos modos. Por eso creé Caiioo.
Ejecuta todos los modelos líderes y modelos abiertos en tu propio hardware. Cambiar de modelo es como cambiar el motor de un coche: tus conversaciones, archivos y ajustes se quedan donde están.
Lleva la IA a tu trabajo. Se accede a archivos, correos y calendarios desde tu propio dispositivo, sin subirlos a otra nube más, y las conversaciones se sincronizan con cifrado de extremo a extremo, de modo que solo tus dispositivos pueden leerlas.
Y muestra a dónde va cada solicitud. La Frontera de Confianza (Trust Boundary) detalla qué empresas de IA reciben tus datos y qué permiten sus términos, y un único interruptor rechaza a cualquier proveedor que pueda entrenar con ellos. Estamos creando los mismos controles para que una empresa pueda convertir su política en papel en reglas válidas para todos.
Empecé Caiioo porque valoro la capacidad, la autonomía y la seguridad. No quiero elegir a un ganador ni depender de una sola empresa de IA; ya existe demasiada concentración de poder. Las empresas necesitan utilizar estas herramientas, proteger sus datos y mantenerse independientes.