Ceci est une traduction automatique du document original en anglais. En cas de divergence entre cette traduction et la version originale anglaise, la version anglaise fera foi. Consulter la version originale en anglais
Le grand pipeline d'entraînement des données personnelles
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
Il est 16 h 40 un jeudi. L'assistant approuvé a atteint sa limite, n'est pas le modèle auquel elle fait confiance pour les contrats, ou ne peut pas accéder au disque où se trouve le contrat. L'échéance n'a pas bougé et l'on attend d'elle qu'elle soit « AI Native ». Alors elle colle le contrat dans son compte personnel ChatGPT et, trente secondes plus tard, obtient une lecture claire et prend une décision.
Personne dans cette histoire ne pense qu'une fuite a eu lieu, et c'est une utilisation parfaitement raisonnable de l'IA. Je pense qu'il s'agit du plus grand pipeline de données du secteur, et il repose sur quelques petits mots dans les conditions d'utilisation.
Deux règlements
Par défaut, OpenAI ne s'entraîne pas sur les données des entreprises clientes, mais pour les particuliers utilisant ChatGPT, elle « peut utiliser votre contenu pour entraîner nos modèles ». Anthropic s'entraîne sur les conversations grand public « lorsque ce paramètre est activé » ; l'utilisation professionnelle et par API en est exemptée. En dehors de l'Europe, l'API gratuite pour développeurs de Google s'entraîne sur ce qu'elle reçoit ; la version payante ne le fait pas. xAI va encore plus loin : dans certaines régions en dehors de l'UE et du Royaume-Uni, si vous utilisez Grok sans vous connecter, vous ne pouvez pas du tout refuser l'entraînement.
Le volet grand public repose sur un postulat simple : quiconque écrit détient ce qu'il saisit et a accepté de le partager. Les conditions d'OpenAI demandent aux utilisateurs de « déclarer et garantir » qu'ils disposent de tous les droits pour le fournir.
Le problème, c'est que ce contrat relève d'informations confidentielles de son employeur, et que les noms qui y figurent constituent des données personnelles d'un client. Ni l'un ni l'autre n'ont donné leur accord, et voilà désormais le document collé au grand papier tue-mouches de la rétention dans le cloud. La peur des licenciements, les attentes de rapidité accrue et la pression d'apparaître « AI Native » ont engendré une violation de données technique, systématique et permanente : une rupture de la confiance des clients et un manquement aux directives écrites de l'entreprise.
La boucle de blanchiment
Selon les conditions grand public, ce qu'elle a collé, sa méthode de travail et ses conclusions peuvent tous devenir des données d'entraînement. Lorsque son entreprise achète plus tard la version pour les entreprises, elle récupère cet apprentissage avec une source blanchie, réutilisée comme un panneau d'aggloméré d'idées et vendue par licence. La séparation entre les conditions personnelles et commerciales forme une boucle de blanchiment pour les données confidentielles et personnelles, ainsi qu'un vecteur de fuite de secrets commerciaux que personne ne surveille. Cela a également un coût : IBM a constaté qu'une organisation sur cinq a subi une violation causée par le shadow AI, et qu'une utilisation intensive du shadow AI a ajouté 670 000 $ à la facture.
Pourquoi une politique n'arrêtera pas la fuite
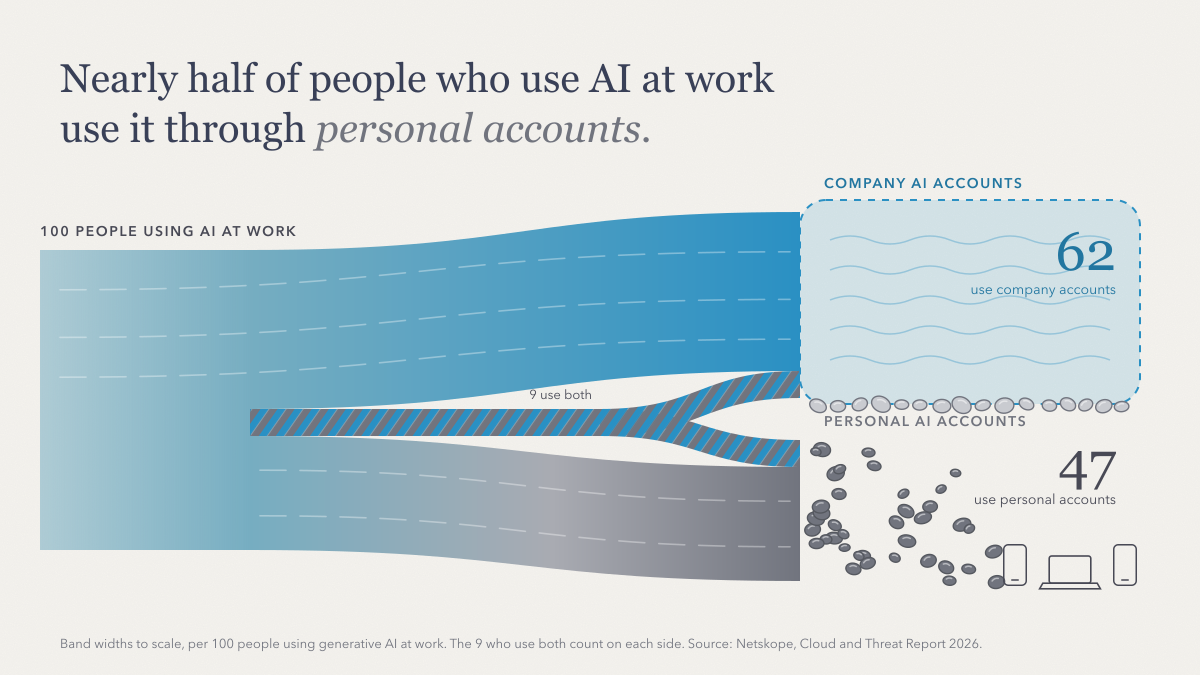
Netskope révèle que 47 % des personnes utilisant l'IA générative au travail utilisent des applications d'IA personnelles, alors que neuf organisations sur dix bloquent déjà au moins une application d'IA. Cela se produit quand même, car il manque une chose à l'outil autorisé : le modèle préféré de l'utilisateur, ou l'accès au fichier, au dépôt ou au système dont dépend le travail. Dans l'enquête de Zapier menée auprès d'entreprises qui paient pour l'IA, 53 % des utilisateurs de comptes personnels préféraient leurs propres outils, et 33 % affirmaient que ceux de l'entreprise ne répondaient pas à leurs besoins. Le blocage ne fait que déplacer le copier-coller vers un téléphone.
Ce qui met fin à la boucle de blanchiment
Je ne pense pas que les laboratoires de recherche soient malveillants. Cette zone grise arrange presque tout le monde : les employés terminent leur travail, les employeurs obtiennent les résultats, les laboratoires récupèrent les données. La seule partie absente de l'accord est celle qui en détient la propriété.
Ce qui y met fin, c'est un outil approuvé que les gens choisiraient de toute façon. C'est pour cela que j'ai créé Caiioo.
Il fait tourner tous les modèles de pointe, ainsi que des modèles ouverts sur votre propre matériel. Changer de modèle équivaut à remplacer le moteur d'une voiture : vos conversations, fichiers et paramètres restent en place.
Il apporte l'IA à votre travail. Les fichiers, courriels et calendriers sont accessibles directement depuis votre appareil, sans être téléversés sur un énième cloud, et les conversations sont synchronisées avec un chiffrement de bout en bout, de sorte que seuls vos appareils peuvent les lire.
Et il montre où va chaque requête. La Trust Boundary répertorie les entreprises d'IA qui reçoivent vos données et ce que permettent leurs conditions, et un simple bouton permet de refuser tout fournisseur susceptible de s'entraîner dessus. Nous développons les mêmes contrôles pour qu'une entreprise puisse transformer sa politique théorique en règles appliquées à tous.
J'ai lancé Caiioo parce que j'accorde de l'importance aux capacités, à l'autonomie et à la sécurité. Je ne veux pas parier sur un vainqueur ni dépendre d'une seule entreprise d'IA ; la concentration de pouvoir est déjà trop forte. Les entreprises doivent pouvoir utiliser ces outils, protéger leurs données et préserver leur indépendance.