Ini adalah terjemahan mesin dari dokumen asli berbahasa Inggris. Jika terjadi perbedaan antara terjemahan ini dan versi asli bahasa Inggris, maka versi bahasa Inggris yang akan berlaku. Baca versi asli bahasa Inggris
Jalur besar pelatihan data pribadi
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
Waktu menunjukkan pukul 16.40 di hari Kamis. Asisten AI yang disetujui perusahaan telah mencapai batas kuotanya, bukan model yang ia percayai untuk memeriksa kontrak, atau tidak dapat mengakses drive tempat kontrak tersebut tersimpan. Tenggat waktu tidak berubah, dan ia dituntut untuk menjadi "AI Native". Jadi, ia menempelkan kontrak tersebut ke akun ChatGPT pribadinya dan, tiga puluh detik kemudian, mendapatkan ringkasan yang mudah dipahami beserta keputusan.
Tidak ada seorang pun dalam cerita tersebut yang merasa ada data yang bocor, dan itu adalah penggunaan AI yang sangat wajar. Menurut saya, ini adalah jalur data terbesar di industri, dan semuanya berjalan hanya melalui beberapa patah kata kecil dalam ketentuan layanan.
Dua buku aturan
Secara default, OpenAI tidak melatih modelnya menggunakan data pelanggan bisnis, tetapi bagi individu yang menggunakan ChatGPT, mereka "dapat menggunakan konten Anda untuk melatih model kami." Anthropic melatih model dengan obrolan konsumen "ketika pengaturan ini aktif"; penggunaan bisnis dan API dikecualikan. Di luar Eropa, API pengembang gratis milik Google melatih model menggunakan apa yang diterimanya; versi berbayar tidak. xAI bahkan melangkah lebih jauh: di beberapa wilayah di luar UE dan Inggris Raya, jika Anda menggunakan Grok tanpa masuk, Anda sama sekali tidak dapat memilih keluar dari pelatihan.
Sisi konsumen bertumpu pada premis yang lugas: siapa pun yang mengetik adalah pemilik apa yang mereka ketik, dan telah setuju untuk membagikannya. Ketentuan OpenAI mewajibkan pengguna untuk "menyatakan dan menjamin" bahwa mereka memiliki hak penuh untuk memberikannya.
Masalahnya adalah kontrak tersebut merupakan informasi rahasia perusahaannya, dan nama-nama di dalamnya adalah data pribadi klien. Tidak ada pihak yang menyetujui apa pun, dan kini data tersebut melekat pada kertas perekat retensi raksasa di cloud. Kekhawatiran akan PHK, ekspektasi waktu pengerjaan yang lebih cepat, dan tekanan untuk terlihat "AI Native" telah menghasilkan pelanggaran data teknis yang sistematis dan terus-menerus: pelanggaran terhadap kepercayaan pelanggan dan kebijakan tertulis perusahaan.
Siklus pencucian data
Berdasarkan ketentuan konsumen, apa yang ia tempelkan, cara ia mengolahnya, dan apa yang ia simpulkan semuanya bisa menjadi data pelatihan. Ketika perusahaannya di kemudian hari membeli versi enterprise, mereka mendapatkan kembali pembelajaran tersebut dengan sumber yang telah dibersihkan, digunakan kembali bagai papan partikel ide, dan dijual per lisensi pengguna. Pemisahan antara ketentuan pribadi dan komersial adalah siklus pencucian bagi data rahasia dan pribadi, serta vektor rahasia dagang yang luput dari pengawasan. Hal ini juga memakan biaya besar: IBM menemukan bahwa satu dari lima organisasi mengalami kebocoran data akibat shadow AI, dan penggunaan shadow AI yang masif menambah beban biaya hingga $670.000.
Mengapa kebijakan tidak akan menghentikan kebocoran
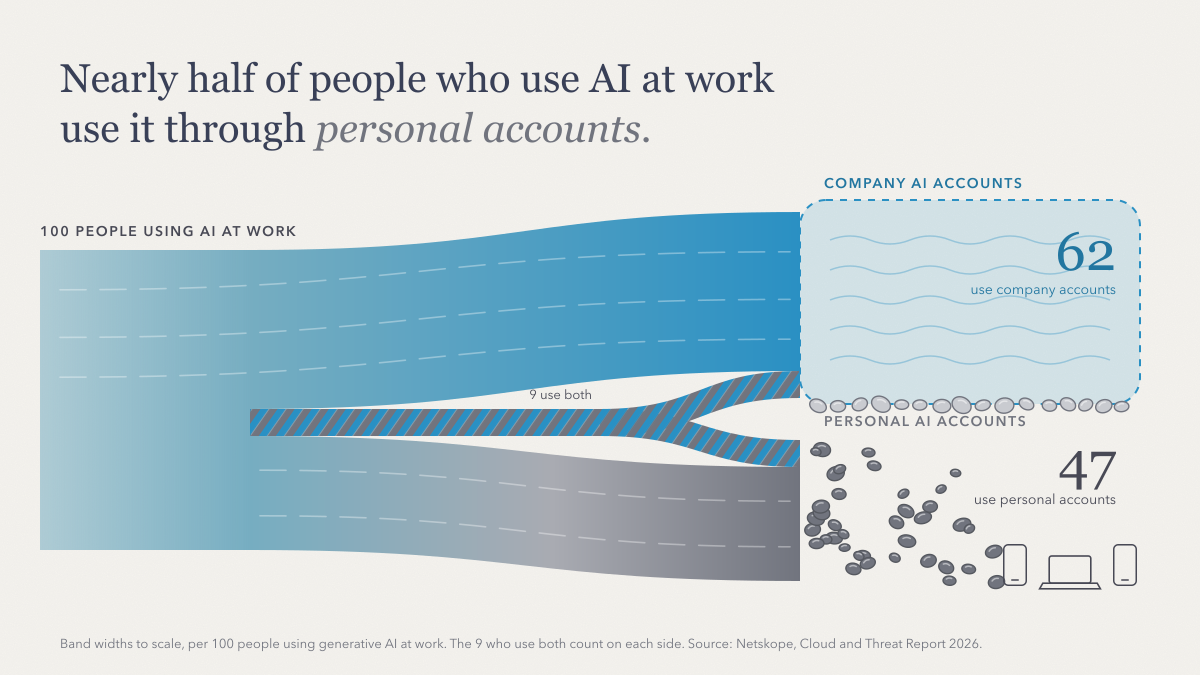
Netskope menemukan bahwa 47% orang yang memanfaatkan AI generatif di tempat kerja menggunakan aplikasi AI pribadi, padahal sembilan dari sepuluh organisasi telah memblokir setidaknya satu aplikasi AI. Hal ini tetap terjadi karena alat yang disetujui kekurangan satu hal: model yang disukai pengguna, atau akses ke berkas, repositori, maupun sistem yang menjadi tumpuan pekerjaan. Dalam survei Zapier terhadap perusahaan yang membayar layanan AI, 53% pengguna akun pribadi lebih memilih alat mereka sendiri, dan 33% mengatakan alat perusahaan tidak memenuhi kebutuhan mereka. Pemblokiran hanya memindahkan aksi penempelan teks ke ponsel.
Apa yang menutup siklus pencucian data
Saya tidak menganggap laboratorium AI sebagai pihak yang jahat. Area abu-abu ini menguntungkan hampir semua orang: karyawan menyelesaikan pekerjaan, pemberi kerja mendapatkan hasilnya, laboratorium mendapatkan datanya. Satu-satunya pihak yang terabaikan dari kesepakatan ini adalah pemilik sah dari data tersebut.
Yang dapat menutup celah ini adalah alat yang disetujui yang memang akan tetap dipilih oleh pengguna. Itulah mengapa saya membangun Caiioo.
Aplikasi ini menjalankan setiap model terkemuka, serta model terbuka di perangkat keras Anda sendiri. Mengganti model seperti mengganti mesin mobil: percakapan, berkas, dan pengaturan Anda tetap di tempatnya.
Caiioo membawa AI langsung ke alur kerja Anda. Berkas, email, dan kalender diakses langsung dari perangkat Anda sendiri, tanpa perlu diunggah ke cloud lain, dan percakapan disinkronkan dengan enkripsi ujung-ke-ujung, sehingga hanya perangkat Anda yang dapat membacanya.
Dan aplikasi ini menunjukkan ke mana setiap permintaan dikirim. Batas Kepercayaan (Trust Boundary) mencantumkan perusahaan AI mana yang menerima data Anda dan apa yang diizinkan oleh ketentuan mereka, serta satu sakelar dapat menolak penyedia mana pun yang mungkin menggunakannya untuk pelatihan data. Kami sedang membangun kontrol serupa agar perusahaan dapat mengubah kebijakan di atas kertas menjadi aturan nyata yang berlaku untuk semua orang.
Saya memulai Caiioo karena saya menghargai kapabilitas, otonomi, dan keamanan. Saya tidak ingin memilih pemenang atau bergantung pada satu perusahaan AI; konsolidasi kekuasaan saat ini sudah terlalu besar. Perusahaan perlu menggunakan alat-alat ini, melindungi data mereka, dan tetap independen.