Dit is een machinevertaling van het originele Engelstalige document. In het geval van een conflict tussen deze vertaling en de originele Engelse versie, is de Engelse versie doorslaggevend. Lees de originele Engelse versie
De grote trainingspijplijn voor persoonsgegevens
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
Het is donderdag 16.40 uur. De goedgekeurde assistent heeft zijn limiet bereikt, is niet het model dat ze vertrouwt voor contracten, of kan niet bij de schijf waar het contract staat. De deadline is onveranderd en er wordt van haar verwacht dat ze "AI-native" is. Dus plakt ze het contract in haar persoonlijke ChatGPT en dertig seconden later heeft ze een begrijpelijke uitleg en een beslissing.
Niemand in dat verhaal denkt dat er iets gelekt is, en het is een volkomen redelijk gebruik van AI. Volgens mij is het de grootste datapijplijn in de sector, en die loopt via een paar kleine woorden in de servicevoorwaarden.
Twee regelboeken
OpenAI traint standaard niet op gegevens van zakelijke klanten, maar voor individuen die ChatGPT gebruiken "kan het uw inhoud gebruiken om onze modellen te trainen." Anthropic traint op chats van consumenten "wanneer deze instelling is ingeschakeld"; zakelijk en API-gebruik is hiervan vrijgesteld. Buiten Europa traint Google's gratis ontwikkelaars-API op wat het ontvangt; de betaalde versie niet. xAI gaat nog verder: in sommige regio's buiten de EU en het VK kunt u zich helemaal niet afmelden voor training als u Grok gebruikt zonder in te loggen.
De consumentenkant rust op een zuiver uitgangspunt: degene die typt, is eigenaar van wat er getypt wordt en heeft ermee ingestemd om het te delen. In de voorwaarden van OpenAI moeten gebruikers "verklaren en garanderen" dat zij het volste recht hebben om dit te verstrekken.
Het probleem is dat het contract vertrouwelijke informatie van haar werkgever is, en de namen erin persoonsgegevens van een klant zijn. Geen van beiden heeft toestemming gegeven, en nu zit het vastgeplakt op de grote retentie-vliegenvanger in de cloud. Angst voor ontslag, verwachtingen van snellere doorlooptijden en de druk om "AI Native" over te komen, hebben geleid tot een systematisch, voortdurend technisch datalek: een schending van het vertrouwen van de klant en van het schriftelijke bedrijfsbeleid.
De witwascyclus
Onder consumentenvoorwaarden kunnen wat ze heeft geplakt, hoe ze het heeft verwerkt en wat ze heeft geconcludeerd allemaal trainingsdata worden. Wanneer haar bedrijf later de zakelijke versie aanschaft, krijgt het die opgedane kennis terug met de bron weggewassen, hergebruikt als spaanplaat van ideeën en verkocht per licentie. De scheiding tussen persoonlijke en commerciële voorwaarden is een witwascyclus voor vertrouwelijke en persoonlijke gegevens, en een vector voor bedrijfsgeheimen waar niemand op let. Het brengt ook kosten met zich mee: IBM ontdekte dat één op de vijf organisaties te maken kreeg met een lek veroorzaakt door schaduw-AI, en intensieve schaduw-AI voegde $ 670.000 toe aan de rekening.
Waarom beleid het lek niet stopt
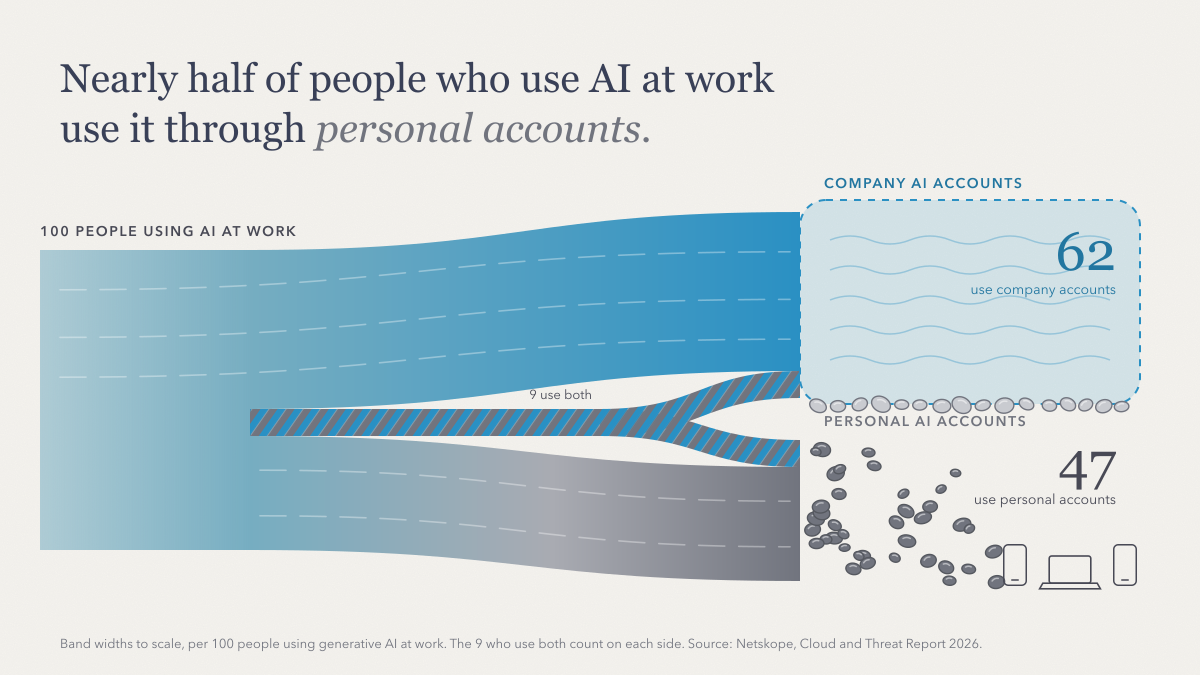
Netskope stelt vast dat 47% van de mensen die generatieve AI op het werk gebruiken, persoonlijke AI-apps gebruikt, terwijl negen op de tien organisaties al ten minste één AI-app blokkeren. Het gebeurt hoe dan ook, omdat de goedgekeurde tool één ding mist: het voorkeursmodel van de medewerker, of toegang tot het bestand, de repository of het systeem waar het werk van afhangt. In Zapiers onderzoek onder bedrijven die betalen voor AI gaf 53% van de gebruikers met een persoonlijk account de voorkeur aan hun eigen tools, en 33% zei dat die van het bedrijf niet aan hun behoeften voldeden. Blokkeren verplaatst het plakken simpelweg naar een telefoon.
Wat de witwascyclus sluit
Ik denk niet dat de AI-labs de schurken zijn. Het grijze gebied komt vrijwel iedereen goed uit: werknemers krijgen het werk af, werkgevers krijgen het resultaat, labs krijgen de data. De enige partij die ontbreekt in deze deal is degene die er eigenaar van is.
Wat de cyclus sluit, is een goedgekeurde tool die mensen hoe dan ook zouden kiezen. Daarom heb ik Caiioo gebouwd.
Het draait elk toonaangevend model, evenals open modellen op je eigen hardware. Wisselen van model is als het vervangen van de motor in een auto: je gesprekken, bestanden en instellingen blijven behouden.
Het brengt de AI naar je werk. Bestanden, e-mail en agenda's worden benaderd vanaf je eigen apparaat en niet geüpload naar nóg een cloud, en gesprekken synchroniseren end-to-end versleuteld, zodat alleen jouw apparaten ze kunnen lezen.
En het toont waar elk verzoek naartoe gaat. De Trust Boundary laat zien welke AI-bedrijven je gegevens ontvangen en wat hun voorwaarden toestaan, en één schakelaar weigert elke provider die erop zou kunnen trainen. We bouwen dezelfde controlemechanismen zodat een bedrijf zijn papieren beleid kan omzetten in regels die voor iedereen gelden.
Ik ben Caiioo gestart omdat ik waarde hecht aan functionaliteit, autonomie en veiligheid. Ik wil geen winnaar kiezen of afhankelijk zijn van één AI-bedrijf; er is al te veel machtsconcentratie. Bedrijven moeten deze tools kunnen gebruiken, hun gegevens beschermen en onafhankelijk blijven.