Ito ay isang machine translation ng orihinal na dokumentong Ingles. Sa kaganapan ng anumang salungatan sa pagitan ng pagsasaling ito at ng orihinal na bersyong Ingles, ang bersyong Ingles ang mangingibabaw. Basahin ang orihinal na bersyong Ingles
Ang malawakang pipeline ng pagsasanay gamit ang personal na data
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
Alas-4:40 ng hapon sa isang Huwebes. Naabot na ng aprubadong assistant ang limitasyon nito, hindi ito ang modelong pinagkakatiwalaan niya para sa mga kontrata, o hindi nito ma-access ang drive kung saan nakalagay ang kontrata. Hindi nagbago ang deadline, at inaasahan siyang maging "AI Native". Kaya ini-paste niya ang kontrata sa kanyang personal na ChatGPT at, pagkalipas ng tatlumpung segundo, mayroon na siyang simpleng paliwanag at isang desisyon.
Walang sinuman sa kuwentong iyon ang nag-iisip na may na-leak, at ito ay isang ganap na makatwirang paggamit ng AI. Sa palagay ko ito ang pinakamalaking data pipeline sa industriya, at tumatakbo ito sa pamamagitan ng ilang maliliit na salita sa mga tuntunin ng serbisyo.
Dalawang hanay ng patakaran
Hindi nagsasanay ang OpenAI sa datos ng mga customer sa negosyo bilang default, ngunit para sa mga indibidwal na gumagamit ng ChatGPT, ito ay "maaaring gumamit ng iyong content upang sanayin ang aming mga modelo." Ang Anthropic ay nagsasanay sa mga chat ng consumer "kapag naka-on ang setting na ito"; hindi saklaw ang paggamit sa negosyo at API. Sa labas ng Europe, ang libreng developer API ng Google ay nagsasanay sa natatanggap nito; ang bayad naman ay hindi. Mas matindi pa ang xAI: sa ilang rehiyon sa labas ng EU at UK, kung gagamitin mo ang Grok nang hindi nagla-log in, hindi ka talaga makakapag-opt out sa pagsasanay.
Nakasalalay ang panig ng consumer sa isang malinaw na saligan: pagmamay-ari ng sinumang nagta-type ang kanilang tina-type, at sumang-ayon silang ibahagi ito. Sa mga tuntunin ng OpenAI, iniaatas sa mga user na "magpatunay at gumagarantiya" na mayroon silang buong karapatang ibigay ito.
Ang problema ay kumpidensyal na impormasyon ng kaniyang employer ang kontrata, at ang mga pangalan dito ay personal na datos ng isang kliyente. Walang inaprubahan ang alinman sa kanila, at ngayon ay nakadikit na ito sa napakalaking flypaper ng pagpapanatili sa cloud. Ang takot sa tanggalan sa trabaho, mga inaasahan para sa mas mabilis na pagtapos ng gawain, at ang panggigipit na magmukhang "AI Native" ay nagbunga ng isang sistematiko at patuloy na teknikal na data breach: isang paglabag sa tiwala ng customer at sa nakasulat na patakaran ng kumpanya.
Ang laundry loop
Sa ilalim ng mga tuntunin para sa consumer, ang kanyang ini-paste, kung paano niya ito pinag-aralan, at kung ano ang kanyang naging konklusyon ay maaaring maging data sa pagsasanay. Kapag binili ng kanyang kumpanya sa kalaunan ang bersyong enterprise, maibabalik nito ang natutunang iyon nang nabura na ang pinagmulan, muling ginamit bilang idea particle board, at ibinebenta bawat user. Ang pagkakahati sa pagitan ng personal at komersyal na mga tuntunin ay isang laundry loop para sa kumpidensyal at personal na data, at isang banta sa trade secret na walang nagbabantay. May malaking gastos din ito: natuklasan ng IBM na isa sa limang organisasyon ay nagkaroon ng breach na dulot ng shadow AI, at ang labis na shadow AI ay nagdagdag ng $670,000 sa kabuuang gastos.
Bakit hindi mapipigilan ng patakaran ang leak
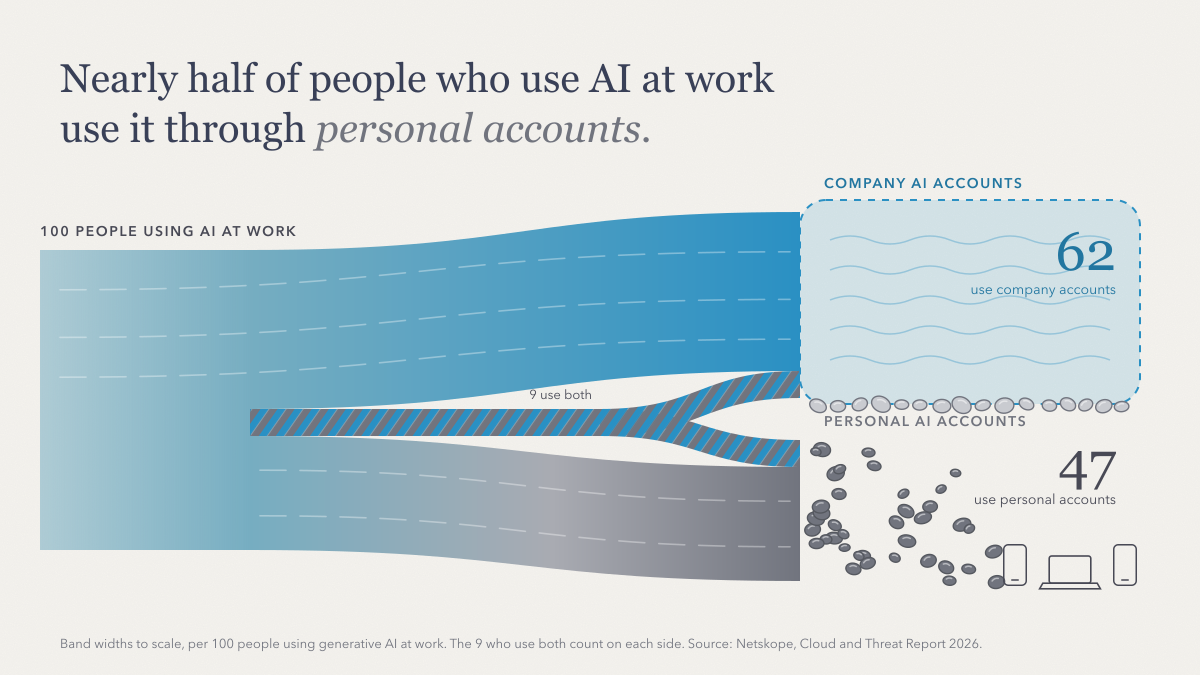
Natuklasan ng Netskope na 47% ng mga taong gumagamit ng generative AI sa trabaho ay gumagamit ng mga personal na AI app, habang siyam sa bawat sampung organisasyon ay nagba-block na ng kahit isang AI app. Nangyayari pa rin ito, dahil may kulang sa isang bagay ang aprubadong tool: ang modelong mas gusto ng tao, o ang access sa file, repository, o sistemang kinakailangan sa trabaho. Sa survey ng Zapier sa mga kumpanyang nagbabayad para sa AI, 53% ng mga user na may personal na account ang mas gusto ang sarili nilang mga tool, at 33% ang nagsabing hindi angkop sa kanilang mga pangangailangan ang gamit ng kumpanya. Nililipat lamang ng pag-block ang pag-paste sa isang telepono.
Ano ang magwawakas sa laundry loop
Hindi ko iniisip na masama ang mga lab. Ang grey area ay pabor sa halos lahat: natatapos ng mga empleyado ang trabaho, nakukuha ng mga employer ang output, at nakukuha ng mga lab ang data. Ang tanging panig na nawawala sa kasunduan ay ang tunay na nagmamay-ari nito.
Ang magwawakas dito ay isang aprubadong tool na pipiliin pa rin ng mga tao. Iyon ang dahilan kung bakit ko ginawa ang Caiioo.
Pinapatakbo nito ang bawat nangungunang modelo, at mga open model sa sarili mong hardware. Ang pagpapalit ng mga modelo ay tulad ng pagpapalit ng makina sa isang kotse: mananatili ang iyong mga pag-uusap, file, at mga setting.
Dinadala nito ang AI sa iyong trabaho. Maaaring i-access ang mga file, email, at kalendaryo mula mismo sa iyong device, hindi ina-upload sa isa na namang cloud, at ang mga pag-uusap ay naka-sync na may end-to-end encryption, kaya ang mga device mo lamang ang makakabasa sa mga ito.
At ipinapakita nito kung saan napupunta ang bawat kahilingan. Inililista ng Trust Boundary kung aling mga kumpanya ng AI ang tumatanggap ng iyong data at kung ano ang pinapayagan ng kanilang mga tuntunin, at isang switch lang ang tatanggi sa anumang provider na maaaring magsanay gamit ito. Binubuo namin ang parehong mga kontrol upang magawang patakaran ng isang kumpanya ang mga nakasulat nito sa papel para sa lahat.
Sinimulan ko ang Caiioo dahil pinahahalagahan ko ang kakayahan, awtonomiya, at seguridad. Ayokong pumili ng panalo o umasa sa iisang kumpanya ng AI; labis na ang konsentrasyon ng kapangyarihan sa kasalukuyan. Kailangang gamitin ng mga kumpanya ang mga tool na ito, protektahan ang kanilang data, at manatiling independyente.