Questa è una traduzione automatica del documento originale in inglese. In caso di discrepanze tra la presente traduzione e la versione originale in inglese, prevarrà la versione inglese. Leggi la versione originale in inglese
La grande pipeline di addestramento sui dati personali
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
Sono le 16:40 di un giovedì. L'assistente approvato ha raggiunto il limite, non è il modello di cui si fida per i contratti o non riesce ad accedere all'unità in cui si trova il contratto. La scadenza non è cambiata e ci si aspetta che lei sia «AI Native». Così incolla il contratto nel suo account personale di ChatGPT e, trenta secondi dopo, ottiene una spiegazione chiara e prende una decisione.
Nessuno in questa storia pensa che sia trapelato qualcosa, ed è un uso perfettamente ragionevole dell'IA. A mio avviso, si tratta della più grande pipeline di dati del settore, e passa attraverso poche semplici parole nei termini di servizio.
Due regolamenti
OpenAI non esegue l'addestramento sui dati dei clienti aziendali per impostazione predefinita, ma per i privati che usano ChatGPT "potrebbe utilizzare i tuoi contenuti per addestrare i nostri modelli." Anthropic si addestra sulle chat degli utenti consumer "quando questa impostazione è attiva"; l'uso aziendale e tramite API è esente. Al di fuori dell'Europa, l'API gratuita per sviluppatori di Google si addestra su ciò che riceve; quella a pagamento no. xAI si spinge ancora oltre: in alcune regioni al di fuori di UE e Regno Unito, se usi Grok senza effettuare l'accesso, non puoi disattivare l'addestramento in alcun modo.
Il versante consumer poggia su una premessa lineare: chi digita è proprietario di ciò che scrive e ha acconsentito a condividerlo. I termini di OpenAI richiedono che gli utenti "dichiarino e garantiscano" di disporre di ogni diritto per fornirlo.
Il problema è che il contratto è un'informazione riservata del datore di lavoro e i nomi in esso contenuti sono dati personali di un cliente. Nessuno dei due ha autorizzato alcunché, e ora è tutto incollato alla grande carta moschicida della conservazione nel cloud. La paura dei licenziamenti, le aspettative di tempi di risposta più rapidi e la pressione a sembrare "AI Native" hanno prodotto una violazione tecnica dei dati sistematica e costante: una violazione della fiducia dei clienti e delle policy aziendali scritte.
Il ciclo di riciclaggio
In base ai termini consumer, ciò che ha incollato, come lo ha elaborato e le conclusioni a cui è giunta possono diventare tutti dati di addestramento. Quando in seguito la sua azienda acquista la versione enterprise, riottiene quell'apprendimento con la fonte ripulita, riutilizzato come truciolato di idee e venduto a licenza utente. La separazione tra termini personali e commerciali è un ciclo di riciclaggio di dati riservati e personali, nonché un vettore di fuga di segreti commerciali che nessuno tiene d'occhio. E ha anche un costo: IBM ha rilevato che un'organizzazione su cinque ha subito una violazione causata dalla shadow AI, e un uso massiccio della shadow AI ha aggiunto 670.000 $ al conto finale.
Perché una policy non fermerà la fuga
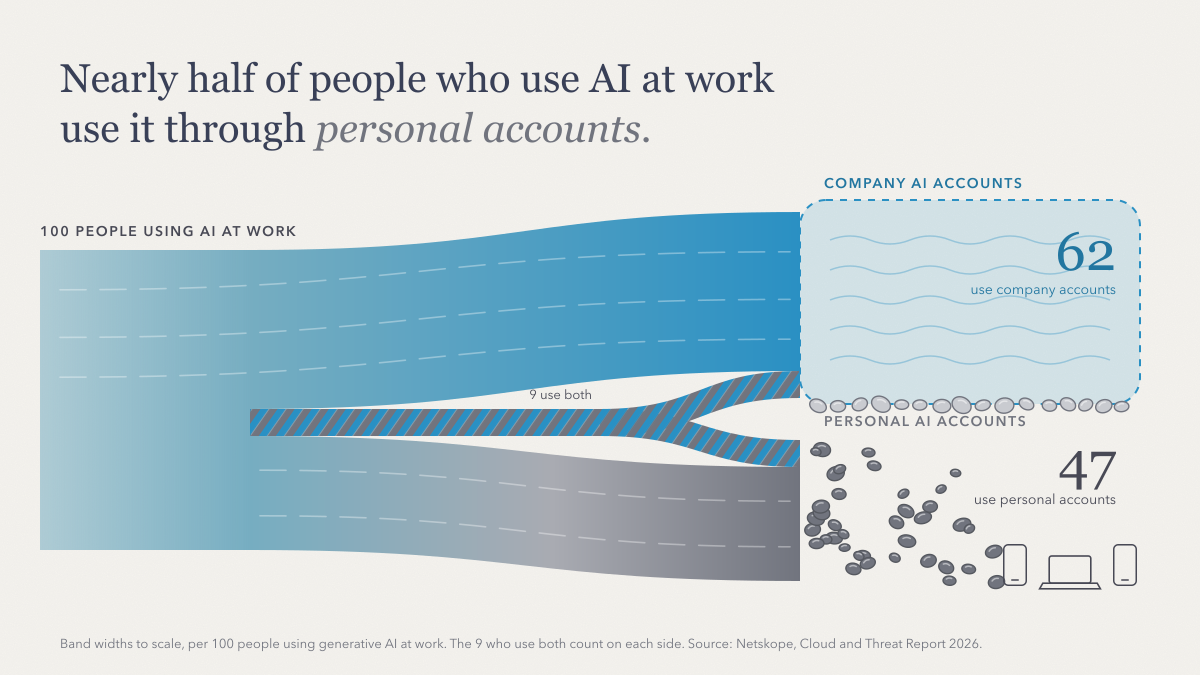
Netskope rileva che il 47% di chi usa l'IA generativa al lavoro si serve di app di IA personali, mentre nove organizzazioni su dieci bloccano già almeno un'app di IA. Accade comunque, perché allo strumento approvato manca qualcosa: il modello preferito dalla persona, oppure l'accesso al file, al repository o al sistema da cui dipende il lavoro. Nel sondaggio di Zapier condotto tra le aziende che pagano per l'IA, il 53% di chi usa account personali preferiva i propri strumenti e il 33% affermava che quelli aziendali non rispondevano alle proprie esigenze. I blocchi si limitano a spostare il «copia e incolla» sullo smartphone.
Come interrompere il ciclo di riciclaggio
Non credo che i laboratori di IA siano i cattivi della storia. La zona grigia fa comodo quasi a tutti: i dipendenti portano a termine il lavoro, i datori di lavoro ottengono i risultati, i laboratori ottengono i dati. L'unica parte tagliata fuori dall'accordo è chi quei dati li possiede.
Ciò che chiude questo ciclo è uno strumento approvato che le persone sceglierebbero comunque. È per questo che ho creato Caiioo.
Esegue tutti i modelli leader e i modelli open sul tuo hardware. Cambiare modello è come sostituire il motore di un'auto: le tue conversazioni, i tuoi file e le tue impostazioni restano al loro posto.
Porta l'IA direttamente nel tuo lavoro. File, email e calendari vengono consultati dal tuo dispositivo, senza essere caricati su un ulteriore cloud, e le conversazioni si sincronizzano con crittografia end-to-end, così che solo i tuoi dispositivi possano leggerle.
Inoltre, mostra dove va a finire ogni richiesta. Il Trust Boundary elenca quali società di IA ricevono i tuoi dati e cosa consentono i loro termini, e un unico interruttore esclude qualsiasi fornitore che potrebbe addestrarsi su di essi. Stiamo sviluppando gli stessi controlli affinché un'azienda possa trasformare la sua policy cartacea in regole valide per tutti.
Ho creato Caiioo perché do valore a capacità, autonomia e sicurezza. Non voglio scommettere su un unico vincitore né dipendere da una sola società di IA; c'è già una concentrazione di potere eccessiva. Le aziende devono poter utilizzare questi strumenti, proteggere i propri dati e rimanere indipendenti.