Niniejszy dokument jest automatycznym tłumaczeniem oryginału w języku angielskim. W przypadku jakichkolwiek rozbieżności między tym tłumaczeniem a oryginalną wersją angielską, wersja angielska jest rozstrzygająca. Przeczytaj oryginał w języku angielskim
Wielki rurociąg trenowania na danych osobowych
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
Jest czwartek, godzina 16:40. Zatwierdzony asystent osiągnął swój limit, nie jest modelem, któremu ufa w kwestii umów, albo nie ma dostępu do dysku, na którym znajduje się umowa. Termin się nie zmienił, a od niej oczekuje się, że będzie „AI Native”. Wkleja więc umowę do swojego prywatnego ChatGPT i trzydzieści sekund później ma zrozumiałe podsumowanie oraz gotową decyzję.
Nikt w tej historii nie uważa, że cokolwiek wyciekło, i jest to całkowicie uzasadnione użycie AI. Moim zdaniem to największy rurociąg danych w branży, a opiera się na kilku drobnych słowach w regulaminie świadczenia usług.
Dwa zbiory zasad
OpenAI domyślnie nie trenuje na danych klientów biznesowych, ale w przypadku osób prywatnych korzystających z ChatGPT „może wykorzystywać Twoje treści do trenowania naszych modeli”. Anthropic trenuje na czatach konsumentów „gdy to ustawienie jest włączone”; wykorzystanie biznesowe i przez API jest z tego zwolnione. Poza Europą bezpłatne API dla programistów od Google trenuje na tym, co otrzymuje; wersja płatna tego nie robi. xAI idzie jeszcze dalej: w niektórych regionach poza UE i Wielką Brytanią, jeśli korzystasz z Groka bez logowania, w ogóle nie możesz zrezygnować z trenowania.
Strona konsumencka opiera się na prostym założeniu: ten, kto pisze, jest właścicielem tego, co wprowadza, i zgodził się to udostępnić. Warunki korzystania OpenAI wymagają od użytkowników „oświadczenia i zapewnienia”, że mają pełne prawo do ich przekazania.
Problem w tym, że umowa stanowi poufne informacje jej pracodawcy, a zawarte w niej nazwiska to dane osobowe klienta. Żadna ze stron niczego nie zatwierdziła, a teraz wszystko to przykleiło się do wielkiego lepu na dane w chmurze. Obawy przed zwolnieniami, oczekiwania szybszych rezultatów i presja, by sprawiać wrażenie „AI Native”, doprowadziły do systematycznego, ciągłego naruszenia bezpieczeństwa danych o charakterze technicznym: naruszenia zaufania klientów oraz spisanych zasad firmy.
Pętla prania danych
Zgodnie z warunkami konsumenckimi to, co wkleiła, sposób, w jaki nad tym pracowała, oraz wnioski, do których doszła, mogą stać się danymi treningowymi. Kiedy jej firma kupi później wersję Enterprise, otrzymuje tę wiedzę z powrotem – z zatartym źródłem, przetworzoną jak płyta wiórowa z pomysłów i sprzedawaną w cenie za stanowisko. Rozdźwięk między warunkami prywatnymi a komercyjnymi to pętla prania poufnych i osobistych danych oraz wektor wycieku tajemnic przedsiębiorstwa, którego nikt nie monitoruje. To także kosztuje: IBM odkryło, że co piąta organizacja doświadczyła naruszenia spowodowanego przez shadow AI, a intensywne korzystanie z nieautoryzowanego AI zwiększyło koszty o 670 000 USD.
Dlaczego polityka firmy nie powstrzyma wycieku
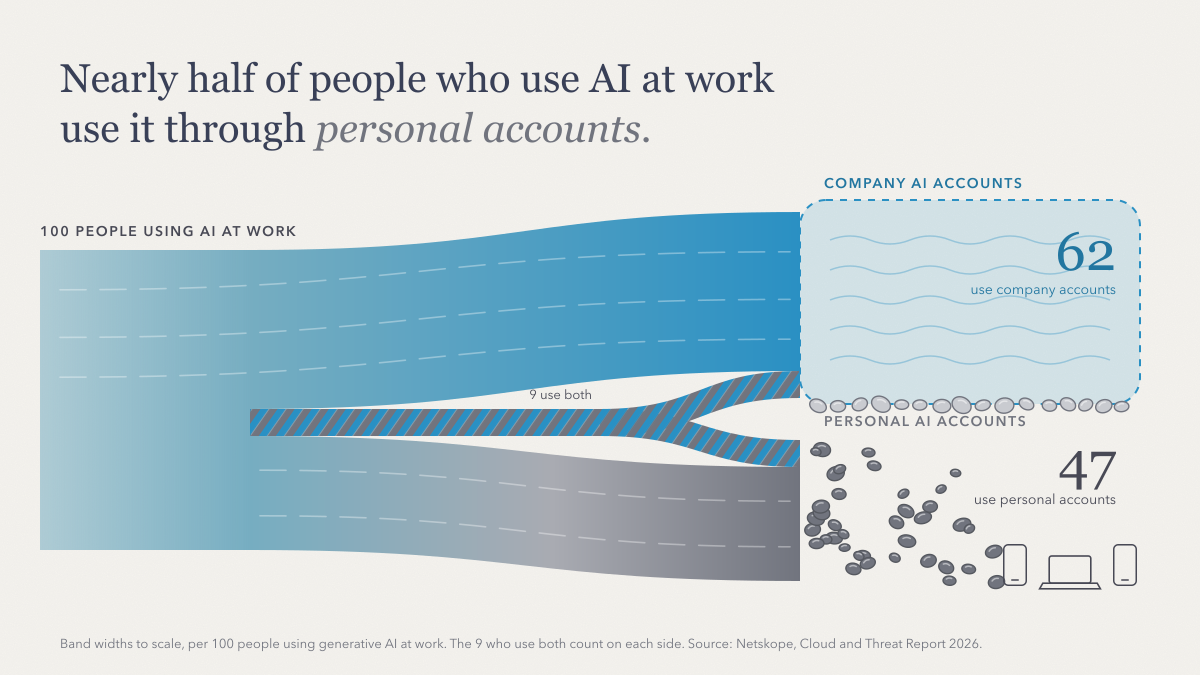
Raport Netskope wskazuje, że 47% osób korzystających z generatywnej sztucznej inteligencji w pracy używa prywatnych aplikacji AI, podczas gdy dziewięć na dziesięć organizacji blokuje już co najmniej jedną aplikację AI. Dzieje się tak mimo to, ponieważ zatwierdzonemu narzędziu brakuje jednej rzeczy: modelu, który dany pracownik preferuje, albo dostępu do pliku, repozytorium czy systemu, od którego zależy jego praca. W badaniu Zapiera przeprowadzonym wśród firm płacących za AI, 53% użytkowników kont prywatnych wolało własne narzędzia, a 33% stwierdziło, że rozwiązania firmowe nie odpowiadają ich potrzebom. Blokowanie przenosi jedynie kopiowanie i wklejanie na telefon.
Co zamyka pętlę prania danych
Nie uważam laboratoriów AI za czarne charaktery. Szara strefa pasuje niemal każdemu: pracownicy kończą pracę, pracodawcy otrzymują rezultaty, laboratoria dostają dane. Jedyną stroną pominiętą w tej transakcji jest prawowity właściciel tych danych.
To, co ją zamyka, to zatwierdzone narzędzie, które ludzie wybraliby tak czy inaczej. Właśnie dlatego stworzyłem Caiioo.
Obsługuje każdy wiodący model oraz modele open-source na Twoim własnym sprzęcie. Zmiana modelu jest jak wymiana silnika w samochodzie: Twoje rozmowy, pliki i ustawienia pozostają nienaruszone.
Przenosi AI do Twojego środowiska pracy. Pliki, poczta i kalendarze są dostępne bezpośrednio z Twojego urządzenia, bez przesyłania ich do kolejnej chmury, a rozmowy synchronizują się z szyfrowaniem end-to-end, dzięki czemu tylko Twoje urządzenia mogą je odczytać.
Pokazuje też, dokąd trafia każde zapytanie. Granica Zaufania (Trust Boundary) wyświetla, które firmy AI otrzymują Twoje dane i na co pozwalają ich regulaminy, a jeden przełącznik pozwala odrzucić każdego dostawcę, który mógłby na nich trenować swoje modele. Tworzymy te same mechanizmy kontroli, aby firma mogła zamienić swoją papierową politykę w reguły obowiązujące każdego.
Stworzyłem Caiioo, ponieważ cenię możliwości, niezależność i bezpieczeństwo. Nie chcę wybierać jednego zwycięzcy ani polegać na jednej firmie AI – konsolidacja władzy jest już i tak zbyt duża. Firmy muszą korzystać z tych narzędzi, chronić swoje dane i zachować niezależność.