Esta é uma tradução automática do documento original em inglês. Em caso de conflito entre esta tradução e a versão original em inglês, a versão em inglês prevalecerá. Ler a versão original em inglês
O grande pipeline de treinamento com dados pessoais
2026-09-24 · Alex Wall, AIGP, CIPM, CIPP/US, CIPP/E, FIP, PLS, CISSP
São 16h40 de uma quinta-feira. O assistente aprovado atingiu o limite, não é o modelo em que ela confia para contratos ou não consegue acessar o drive onde o contrato está. O prazo final não mudou e espera-se que ela seja "Nativa em IA". Então, ela cola o contrato no seu ChatGPT pessoal e, trinta segundos depois, tem uma interpretação em linguagem simples e uma decisão.
Ninguém nessa história pensa que algo vazou, e é um uso perfeitamente razoável da IA. Eu acredito que este seja o maior pipeline de dados do setor, e ele passa por poucas palavras discretas nos termos de serviço.
Dois conjuntos de regras
A OpenAI não treina com dados de clientes corporativos por padrão, mas para pessoas físicas que usam o ChatGPT ela "pode usar seu conteúdo para treinar nossos modelos." A Anthropic treina com conversas de consumidores "quando esta configuração está ativada"; o uso empresarial e de API está isento. Fora da Europa, a API gratuita para desenvolvedores do Google treina com o que recebe; a paga, não. A xAI vai ainda mais além: em algumas regiões fora da UE e do Reino Unido, se você usar o Grok sem fazer login, não é possível recusar o treinamento de forma alguma.
O lado do consumidor baseia-se em uma premissa simples: quem digita é dono do que digita e concordou em compartilhar. Os termos da OpenAI exigem que os usuários "declarem e garantam" que têm todo o direito de fornecê-lo.
O problema é que o contrato é informação confidencial do empregador dela, e os nomes nele contidos são dados pessoais de um cliente. Nenhum dos dois aprovou nada, e agora isso está preso no grande papel pega-moscas de retenção na nuvem. O medo de demissões, as expectativas de prazos mais rápidos e a pressão para parecer "nativo em IA" produziram uma violação técnica de dados sistemática e constante: uma violação da confiança do cliente e da política escrita da empresa.
O ciclo de lavagem
Sob os termos de consumidor, o que ela colou, como trabalhou nisso e o que concluiu podem se tornar dados de treinamento. Quando a empresa dela adquire posteriormente a versão empresarial, recebe esse aprendizado de volta com a fonte apagada, reaproveitado como aglomerado de ideias e vendido por licença. A divisão entre termos pessoais e comerciais é um ciclo de lavagem para dados confidenciais e pessoais, e um vetor de segredos comerciais que ninguém está monitorando. E isso custa caro: a IBM constatou que uma em cada cinco organizações sofreu uma violação causada por shadow AI, e o uso intenso de shadow AI adicionou US$ 670.000 à conta.
Por que uma política não vai impedir o vazamento
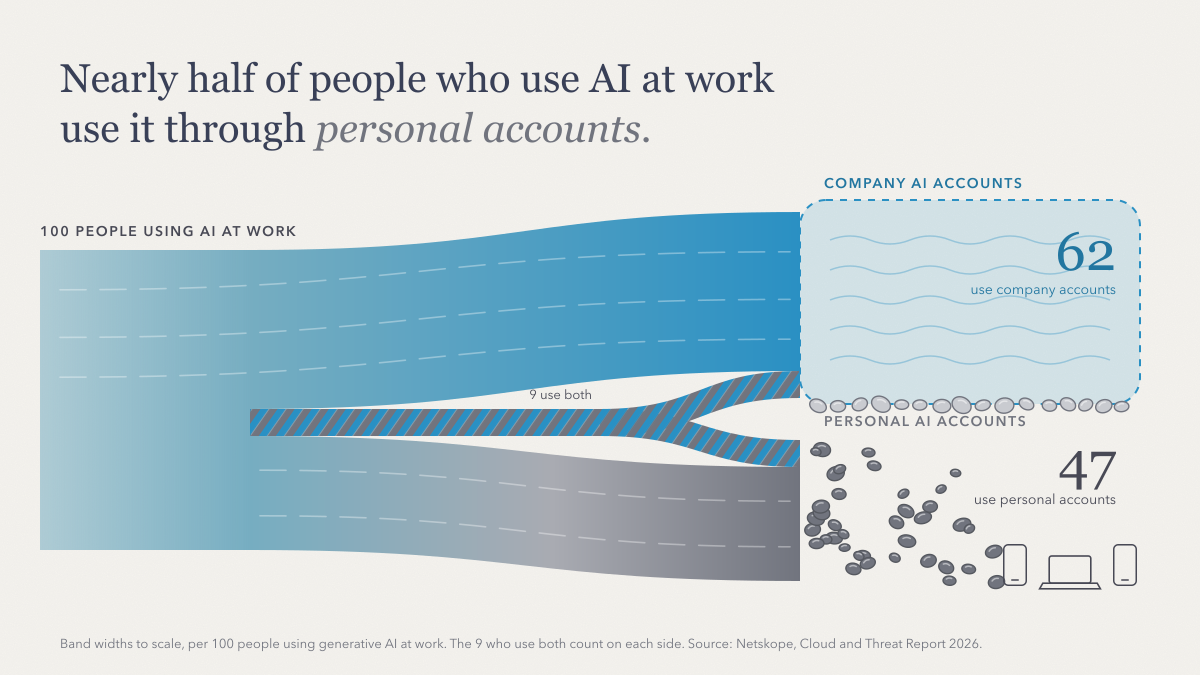
A Netskope aponta que 47% das pessoas que utilizam IA generativa no trabalho usam aplicativos pessoais de IA, enquanto nove em cada dez organizações já bloqueiam pelo menos um aplicativo de IA. Isso acontece de qualquer maneira, porque a ferramenta aprovada não tem uma coisa: o modelo de preferência da pessoa ou o acesso ao arquivo, repositório ou sistema do qual o trabalho depende. Na pesquisa da Zapier com empresas que pagam por IA, 53% dos usuários de contas pessoais preferiram suas próprias ferramentas, e 33% disseram que a da empresa não atendia às suas necessidades. O bloqueio apenas transfere a cópia e colagem para o celular.
O que fecha o ciclo de lavagem
Não acho que os laboratórios sejam vilões. A zona cinzenta convém a quase todos: os funcionários concluem o trabalho, os empregadores obtêm o resultado, os laboratórios recebem os dados. A única parte ausente do acordo é quem detém a propriedade deles.
O que fecha esse ciclo é uma ferramenta aprovada que as pessoas escolheriam de qualquer forma. Foi por isso que criei o Caiioo.
Ele executa todos os principais modelos, além de modelos abertos no seu próprio hardware. Trocar de modelo é como trocar o motor de um carro: suas conversas, arquivos e configurações permanecem no mesmo lugar.
Ele traz a IA para o seu trabalho. Arquivos, e-mails e calendários são acessados a partir do seu próprio dispositivo, sem serem enviados para mais uma nuvem, e as conversas são sincronizadas com criptografia de ponta a ponta, para que apenas os seus dispositivos possam lê-las.
E ele mostra para onde cada solicitação vai. O Trust Boundary lista quais empresas de IA recebem seus dados e o que os termos delas permitem, e uma única chave recusa qualquer provedor que possa treinar com eles. Estamos construindo os mesmos controles para que uma empresa possa transformar sua política no papel em regras válidas para todos.
Comecei o Caiioo porque valorizo capacidade, autonomia e segurança. Não quero escolher um vencedor nem depender de uma única empresa de IA; já existe concentração excessiva de poder. As empresas precisam usar essas ferramentas, proteger seus dados e continuar independentes.